

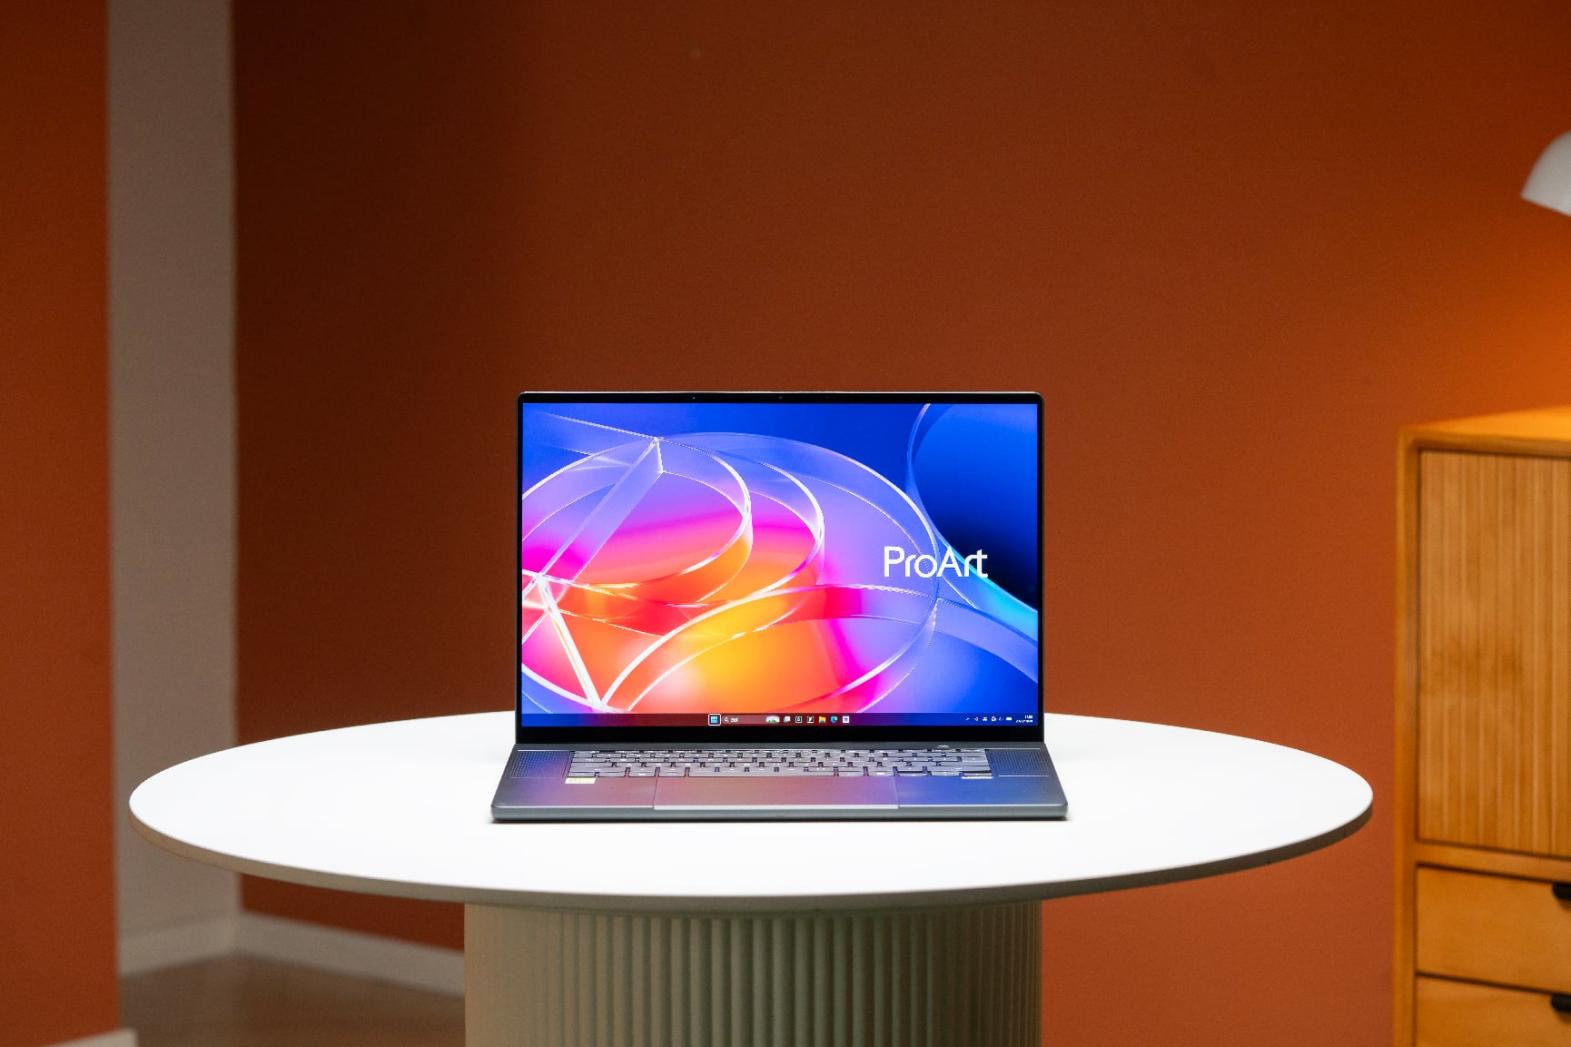
当NVIDIA以“PC的全新开始”定义RTX Spark平台时,许多人仍觉得这只是技术愿景。但数月后,搭载RTX Spark N1X的笔记本已正式开售,而华硕ProArt 创16 RTX Spark便是代表之作。这台16英寸笔记本所搭载的NVIDIA RTX Spark N1X超级芯片,将20核Arm架构的CPU与6144个CUDA核心的Blackwell GPU整合进一颗SoC,搭配最高128GB统一内存,机身薄至12.9mm、轻约1.79kg——它试图打破大众“轻薄”与“高性能”不可兼得的认知。当本地大模型推理、AI智能体、专业渲染与光追游戏都被压缩进一台便携设备时,端侧AI元年是否真的到来?让我们通过对华硕ProArt 创16 RTX Spark深入的测评与体验来寻找答案吧。
NVIDIA RTX Spark N1X简介
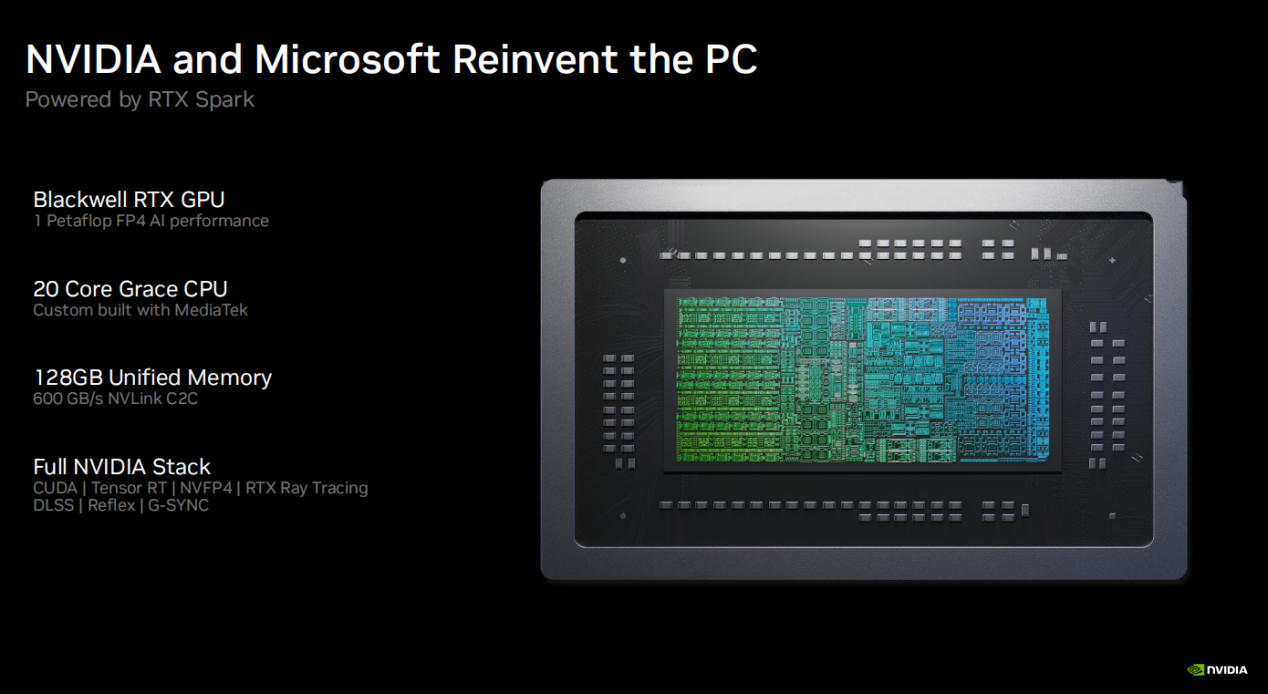
NVIDIA对RTX Spark的描述:“RTX Spark是Windows PC 的一个新起点,专为创作者、玩家和AI智能体而打造”。实际上,NVIDIA已经预见到在AI智能体时代,端侧AI不再局限于聊天,而是要实现“在多工具、多文件之间智能工作”,而要让PC实现这样的应用,首先就要解决显存容量和内存带宽这两大瓶颈,RTX Spark最高可配备128GB统一内存,可以将以前需要高端计算卡或者数据中心才能加载的大模型塞进笔记本或者迷你机里,就是为了解决这样的应用痛点。
值得注意的是,NVIDIA RTX Spark N1X并不是一颗独立的单功能芯片,也非简单地将“CPU+GPU”拼在一起的“胶水芯片”。它实际上是一颗堪称“超级芯片”的高度集成化SoC。它由NVIDIA Grace CPU与RTX Blackwell GPU组成,这两部分通过NVIDIA NVLink-C2C片内高速互连进行通信,而CPU与GPU则共享统一内存的容量。
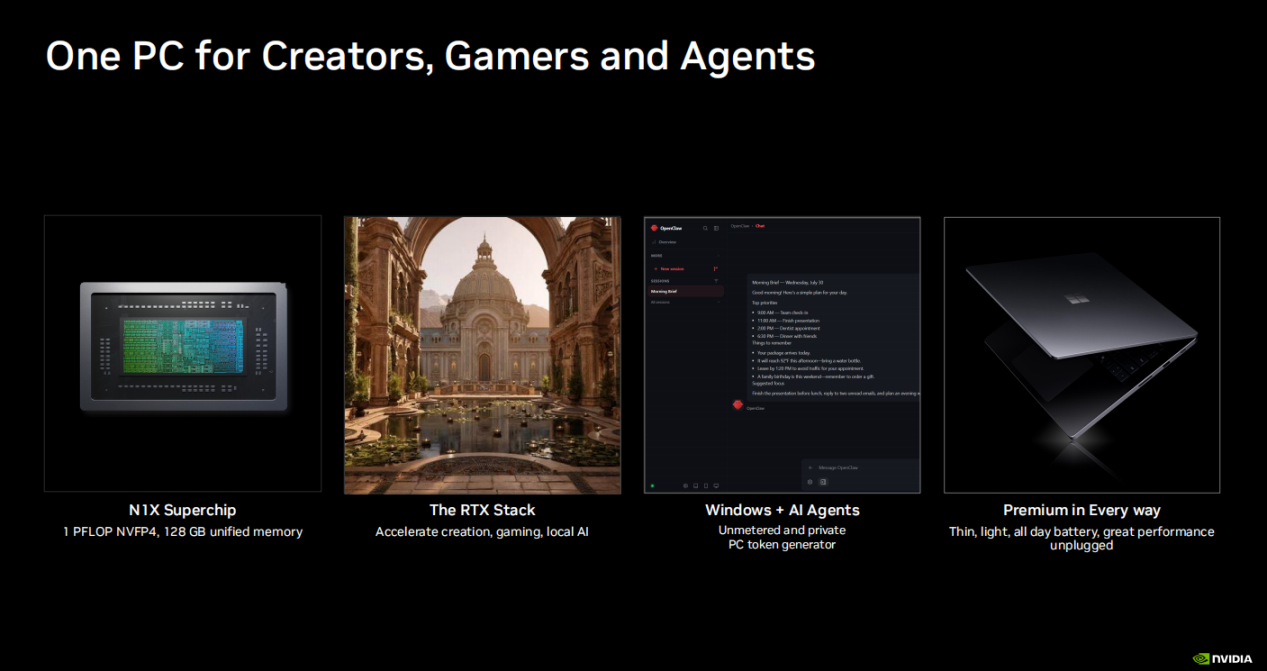
此外,NVIDIA RTX Spark N1X还拥有无可比拟的CUDA生态圈,这个生态圈与NVIDIA RTX PRO专业GPU、DGX Spark、DGC Station甚至是GeForce RTX消费级GPU的生态圈是一致的。这就意味着海量的现成AI框架、推理运行时和开发工具、APP可以很轻松地“拿来就用”,省去了迁移和重复开发的麻烦。同时,创作者常用的Blender、DaVinci Resolve、Affinity、Adobe Photoshop等等应用也拥有对应的Arm原生版,游戏玩家关心的RTX、DLSS、G-SYNC、Reflex和ACE也一应俱全。从这一点来讲,NVIDIA RTX Spark N1X算得上是把专业创作、AI智能体应用与开发、RTX游戏娱乐三大应用领域集成在一起的超级解决方案,也是NVIDIA在移动SoC上超越时代的创新。
目前登场的RTX Spark N1X包括两款型号,两者在架构与内存子系统设计上完全相同,只是在核心单元数上有所区别,RTX Spark的CPU和GPU都采用TSMC 3nm工艺,整体TDP为45W~80W可调。顶配款RTX Spark N1X-6144的GPU拥有48组SM单元、搭载6144个CUDA核心,CPU部分拥有20核(10个X925+10个A725)。其中Cortex-X925性能核最高频率可达4.1GHz,A725能效核则是2.8GHz。另一款RTX Spark N1X-5120的GPU拥有40组SM单元和5120个CUDA核心,CPU部分则配备18个核心(9个X925+9个A725)。
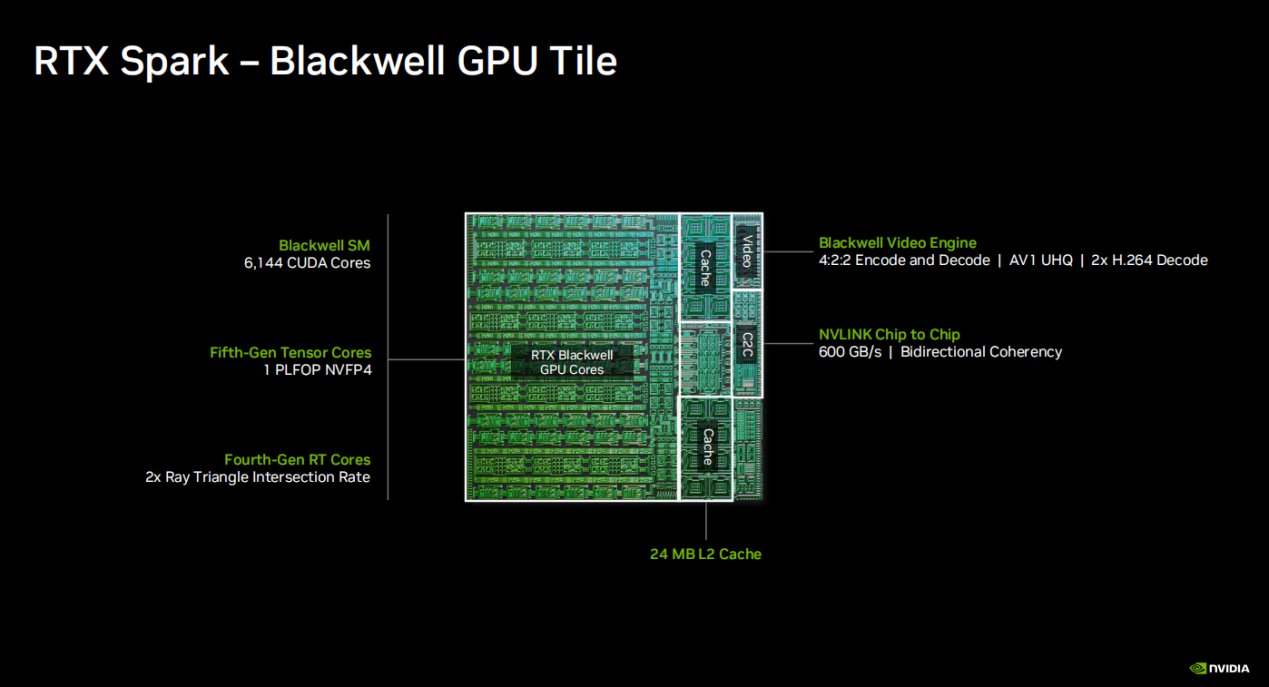
RTX Spark N1X的GPU部分堪称算力的核心动力源泉,它采用Blackwell架构,配备第四代RT Core与第五代Tensor Core,这就意味着它也支持DLSS 5的“3D引导神经网络渲染”。此外,它也原生支持NVFP4低精度数据格式,特别适合端侧快速高效处理AI应用。当然,它也可以完美支持光追/路径追踪,为玩家提供出色的游戏画面。
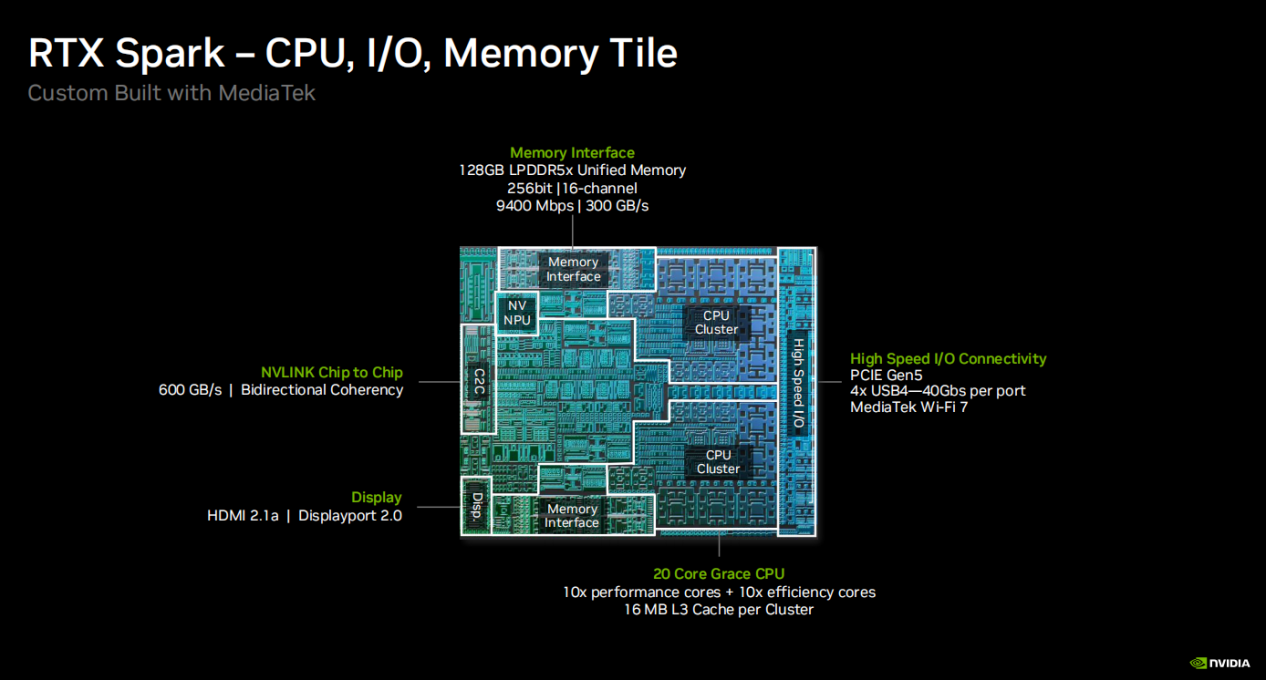
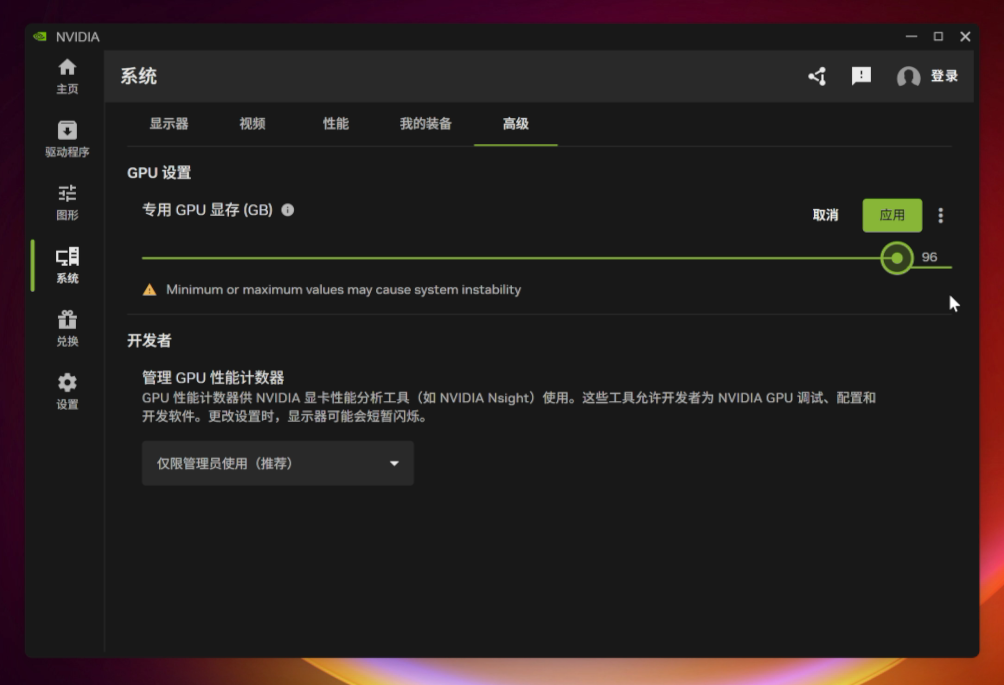
RTX Spark N1X的CPU部分代号Grace,采用Arm架构,拥有10个性能核和10个能效核,搭配总共24MB的三级缓存,I/O部分可支持PCIe 5.0、最多4个USB4(40Gbps),HDMI 2.1a和DP 2.0视频输出。CPU与GPU之间通过NVLink-C2C进行连接,带宽高达600GB/s,这样的设计使得它们可以共享统一内存架构,最高可共享128GB LPDDR5X 9400MT/s内存(256bit/16通道),其中显存最高可手动分配96GB,让系统可以更轻易地装下更大的AI模型,从而在便携的笔记本上就能实现百亿级大模型的本地运行能力。
由于RTX Spark N1X的CPU部分采用Arm架构,可能有用户会担心其与现有X86应用的兼容性。实际上,这个平台在生态和兼容性方面已经有了很大变化。
微软与NVIDIA联合,针对RTX Spark的架构做了深度优化,包括工作负载配置调度,启用微软电源与热框架,更智能地协调性能、功耗与散热。在统一内存的使用方面,Windows也做了适配。兼容方面,RTX Spark配备的Windows系统可以支持原生Arm64程序和通过Prism兼容层运行的x86/x64程序。Prism是Windows内置的模拟层,无需重新编译即可在Arm PC上运行32位x86与64位x64软件。值得注意的是,Prism只负责转译x86/x64的CPU指令,GPU运行的代码无需转译,所以GPU计算时不需要承担转译开销。
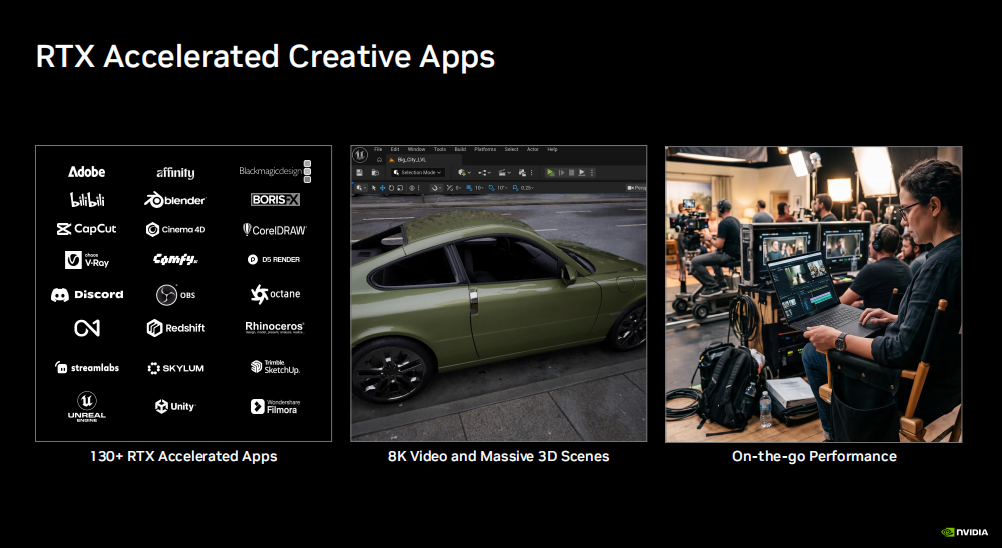
目前Blender、DaVinci Resolve、Affinity、Adobe Photoshop等专业创作软件都已提供原生Arm版。从这一点来看,对于大多数的设计师用户来讲,他们使用RTX Spark并不会有什么明显的不适应。当然,毕竟x86/x64与Arm是两套不同的底层架构,对于微软和NVIDIA来说确实还有更多的兼容性优化工作需要做,不过在两大生态圈巨头联手的情况下,相信这个过程会非常快。
华硕ProArt 创16 RTX Spark专业AI智能体轻薄本赏析
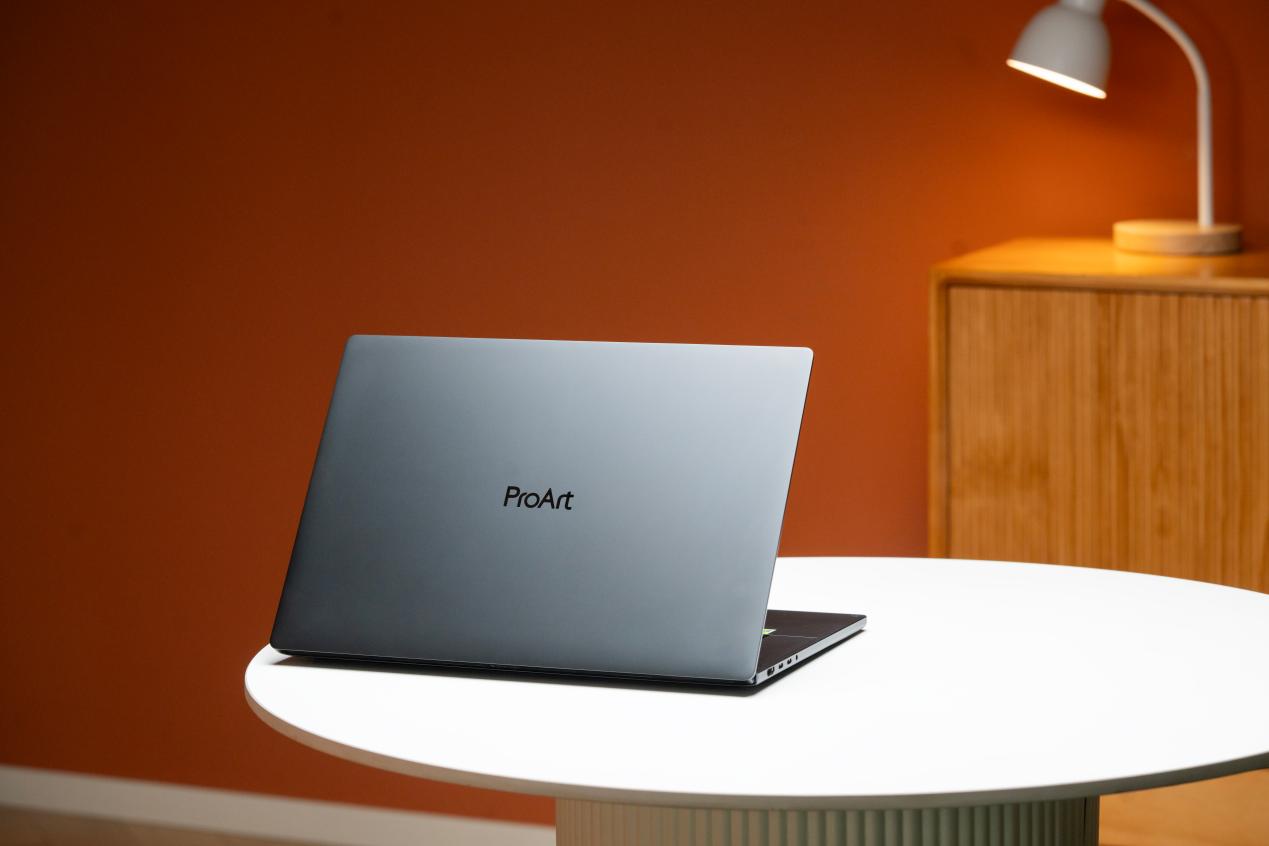
华硕ProArt 创16 RTX Spark专为需要随身AI智能体的用户量身定做,在外观、质感和便携性方面尤其抢眼。笔记本机身薄至12.9mm、轻约1.79kg,是华硕迄今最薄的16英寸ProArt系列创作本,放在背包里带走毫无压力,可以说同时兼顾了大屏创作与日常便携。外壳方面,纳米黑配色的机身表面经过特殊处理,可抵御指纹与污渍,长久保持外观洁净,触摸质感也非常舒适。同时,笔记本也通过了多项严苛质量测试,具备出色的耐用性与可靠性。
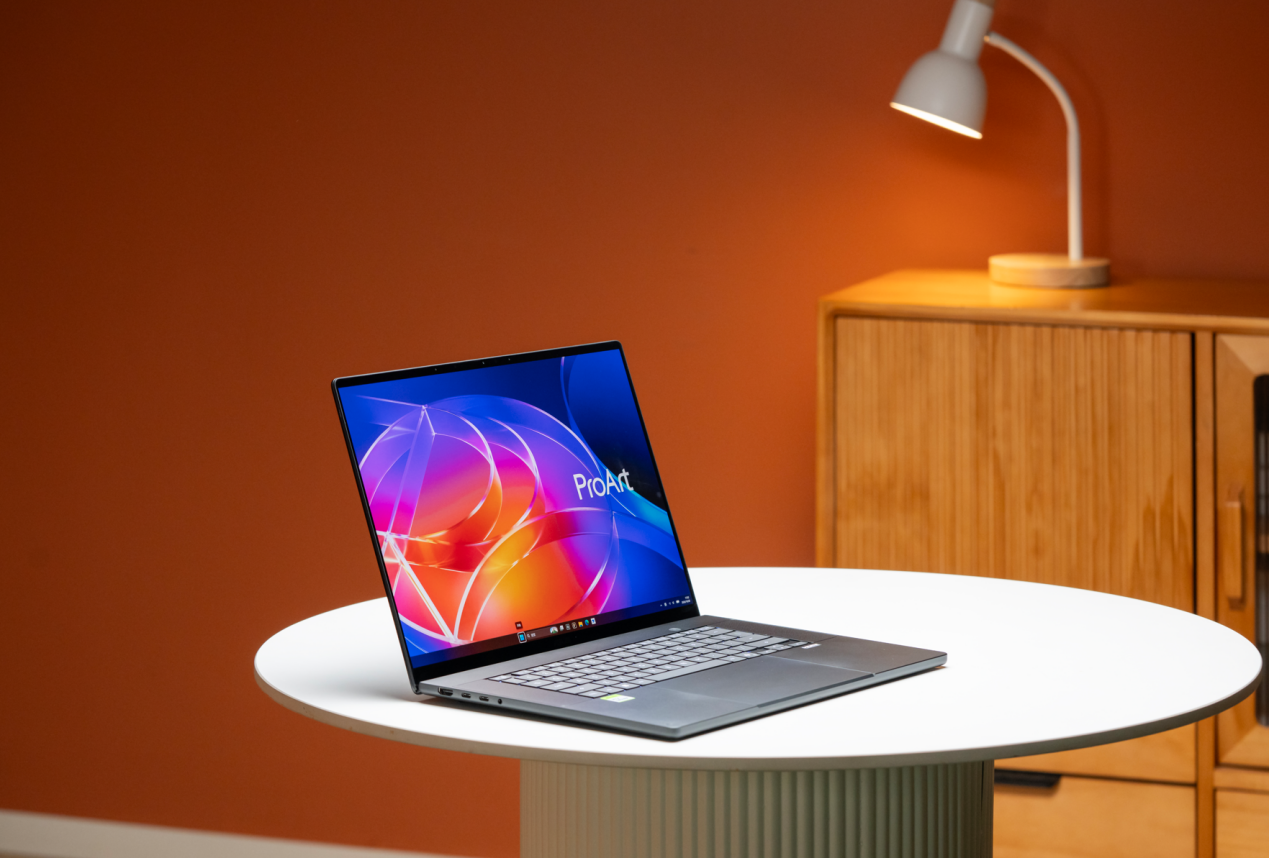
华硕ProArt 创16 RTX Spark搭载了华硕Lumina Pro OLED屏幕,采用16英寸16:10比例设计,拥有4K超高分辨率和120Hz高刷新率,峰值亮度可达1600nits,通过了VESA DisplayHDR True Black 1000认证,提供100% DCI-P3广色域,同时也具备Delta E<1专业级色准,满足专业创作对色彩还原的严苛要求。屏幕表面还拥有抗反射涂层,可减少环境反光,降低长时间使用带来的视觉疲劳。同时,屏幕还支持触控,满足更多使用环境下的需求。
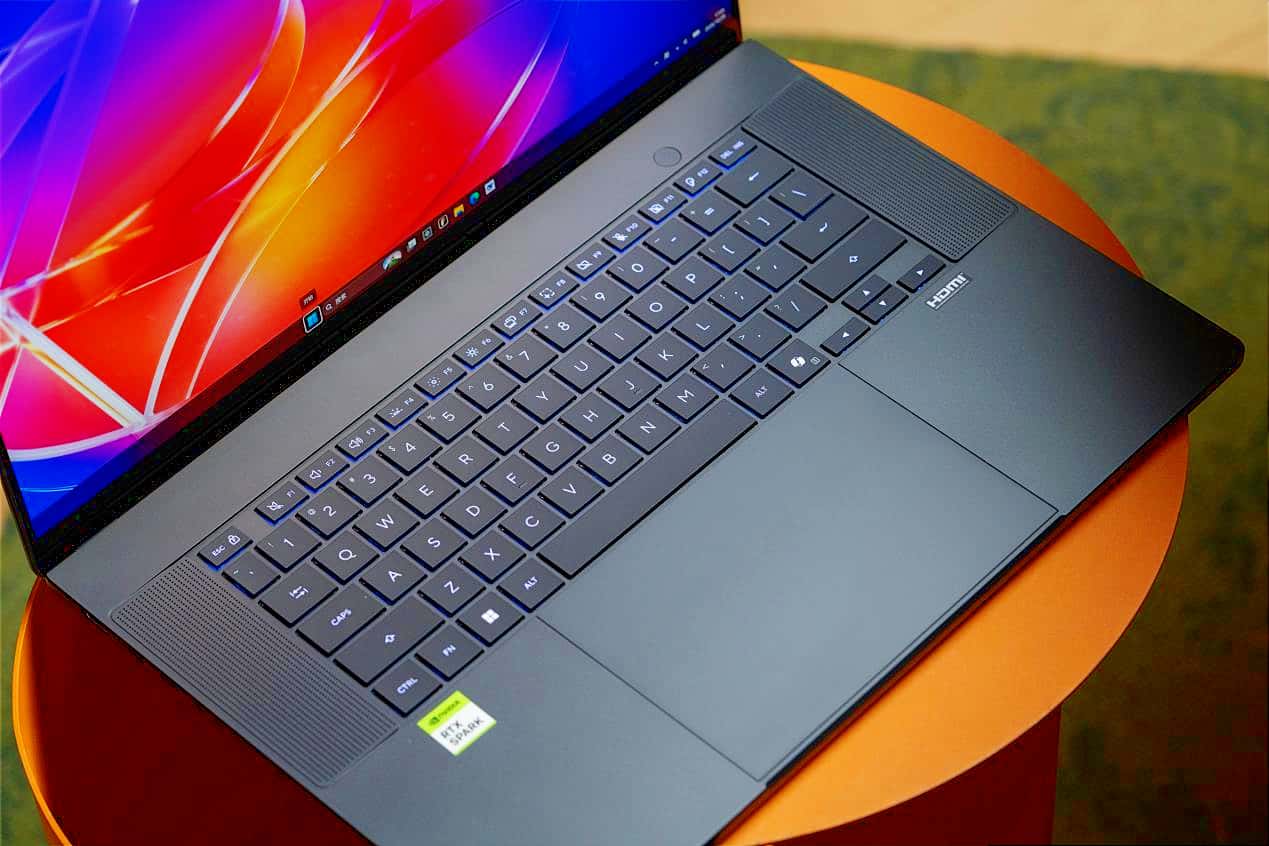
其C面除了手感舒适的1.7mm长键程键盘之外,还配备了华硕7.1英寸超大触控板,采用无边框玻璃面板设计,触控操作非常丝滑。
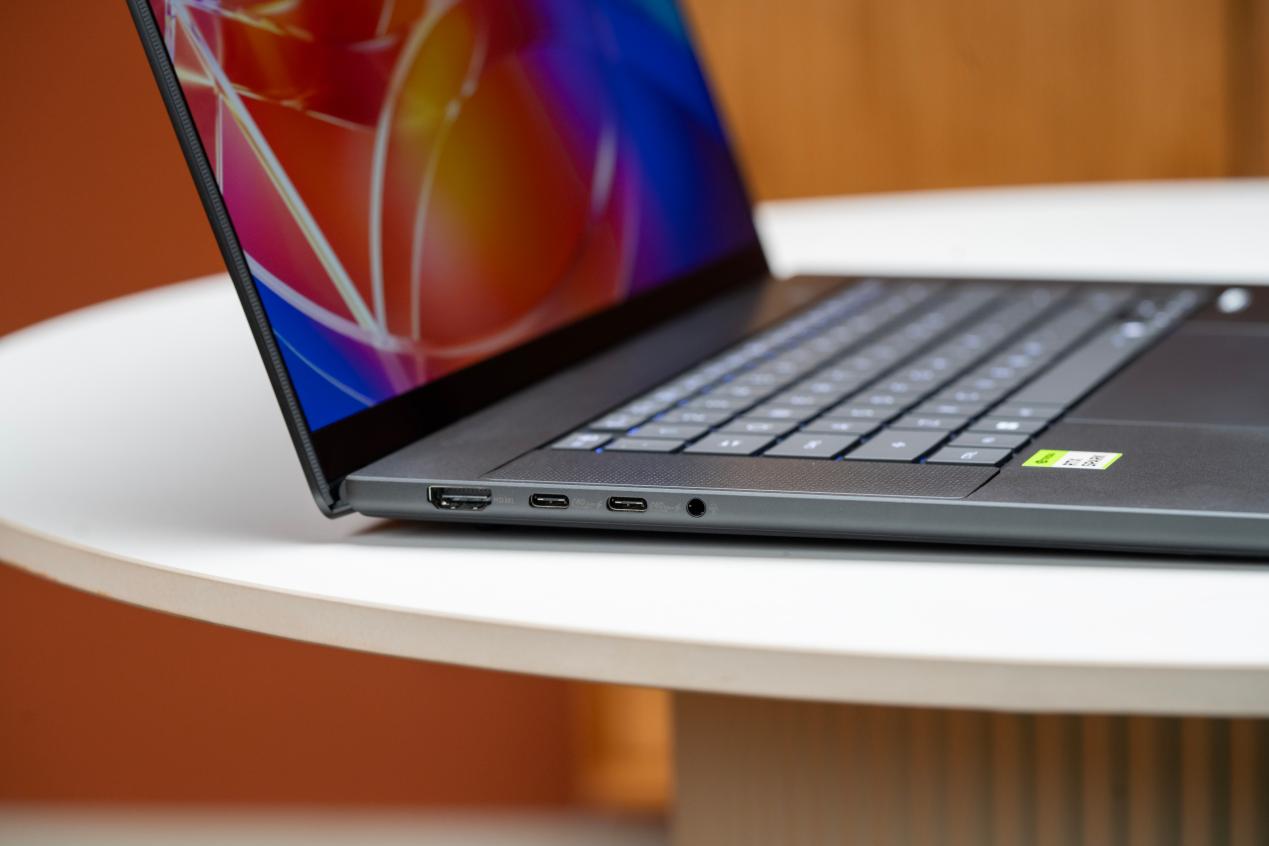
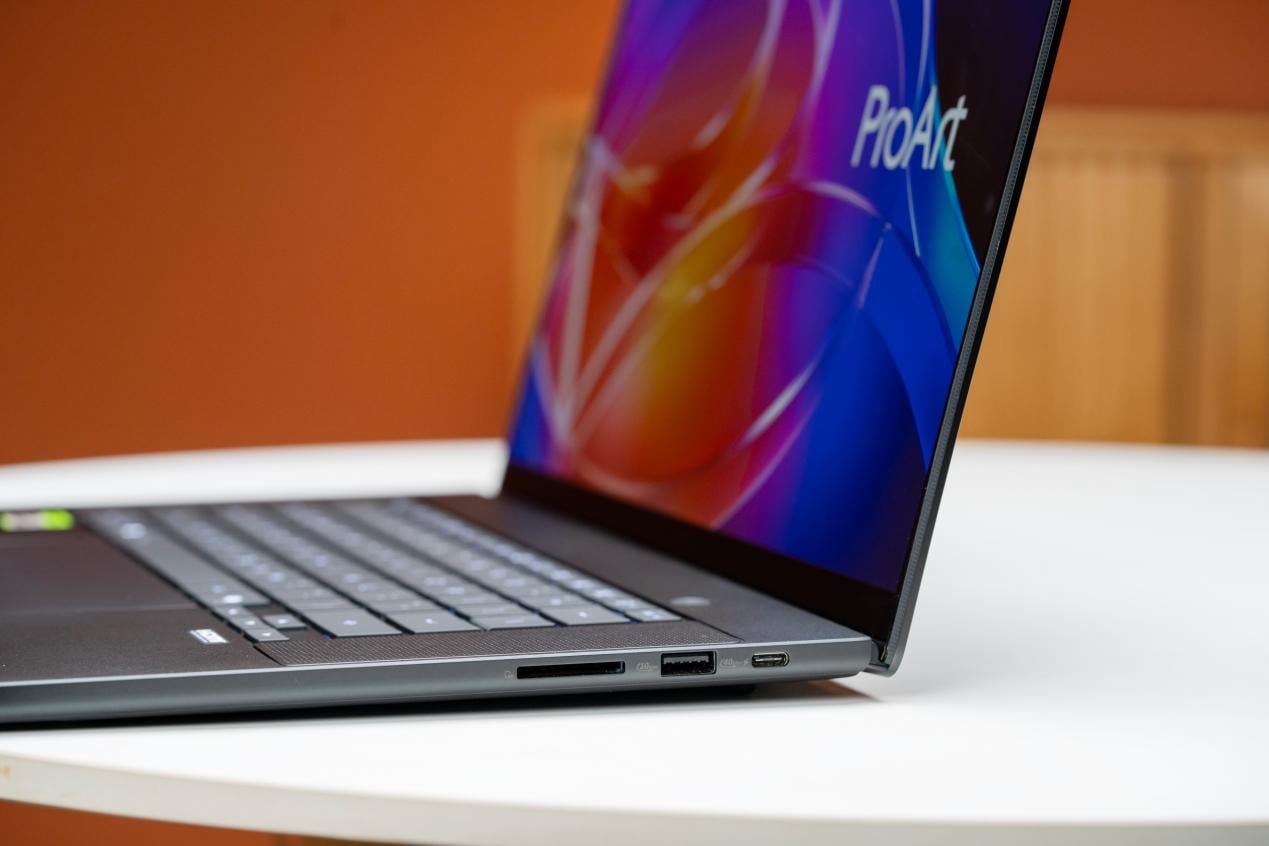
接口方面,华硕ProArt 创16 RTX Spark配置齐全。它拥有3个40Gbps USB4.0 Type-C接口,支持视频信号输出与供电。另外还有1个USB3.2 Gen2 Type-A、1个HDMI 2.1 FRL、1个SD Express7.0读卡器以及音频接口。无线连接方面,它搭载了Wi-Fi7无线网卡与蓝牙5.4。对于创作者和开发者来说,3个USB4.0 Type-C接口可同时外接显示器、高速存储和供电设备,HDMI2.1 FRL方便会议投屏或外接大屏,SD Express7.0读卡器则照顾到摄影、摄像素材的快速导入,日常创作和外接扩展基本无需额外扩展坞。
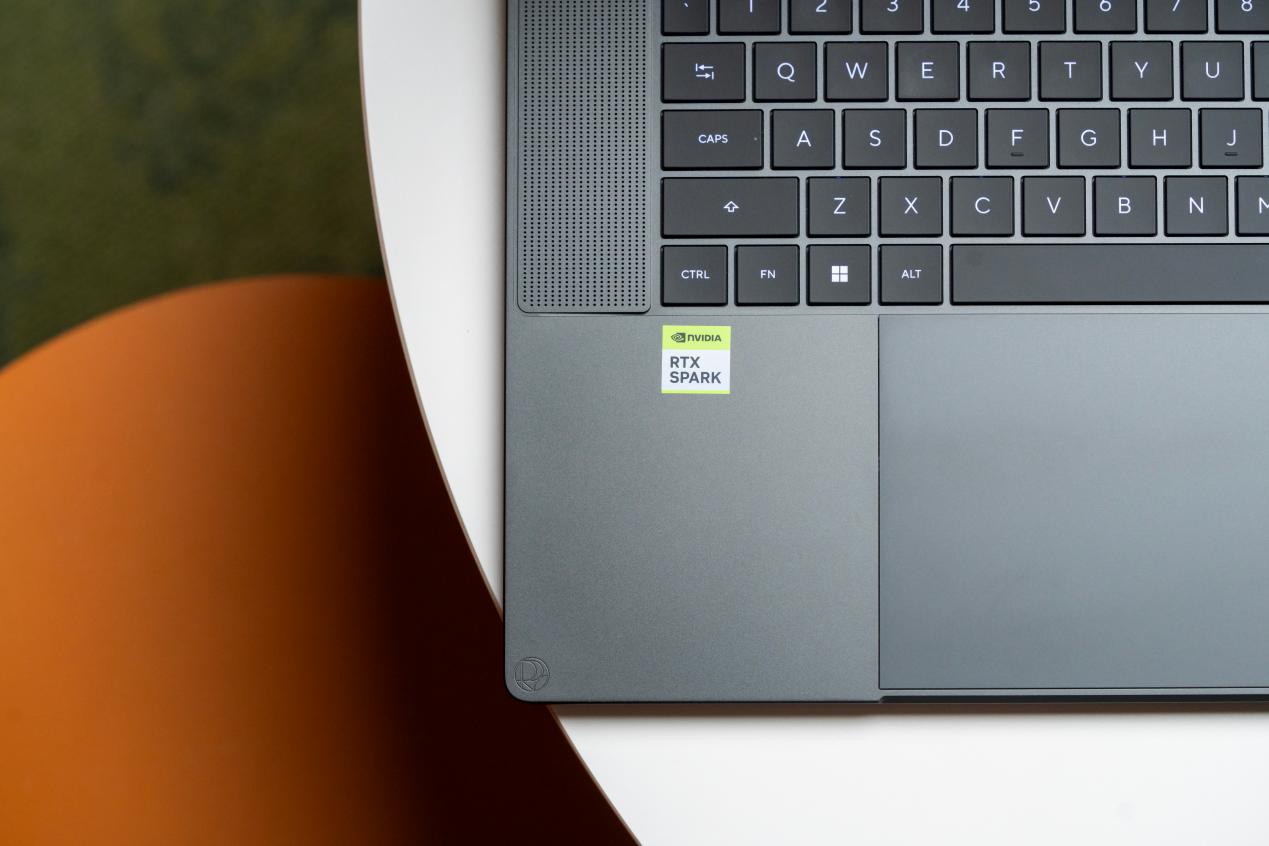
硬件部分,它搭载了NVIDIA RTX Spark N1X处理器,内置6144个CUDA核心的NVIDIA Blackwell RTX GPU与高达20核的 NVIDIA Grace CPU(内部通过NVLink-C2C直连,数据带宽高达600GB/s),FP4算力高达1 Petaflop,支持CUDA原生运行,配备128GB LPDDR5X 9400MT/s统一内存,最高支持加载运行120B参数级别的大模型,更支持百万Token超长上下文,适合复杂大模型本地操作、本地部署实现Token自由,兼顾效率、成本与数据隐私。存储方面,笔记本则提供2个M.2 2280 PCIe 5.0 x 4插槽,方便后续加装或升级固态硬盘(本机已使用1个M.2插槽搭载了1TB SSD)。
续航部分,笔记本搭载了99.9Wh大容量电池,能够满足全天外出差旅、移动创作和长时间会议等场景需求,减少对插座的依赖。对于经常需要外出拍摄、现场剪辑或移动办公的创作者来讲,大电池带来的续航余量意味着更从容的工作节奏。
接下来就让我们看看它在实战体验中的表现。
AI应用测试与体验
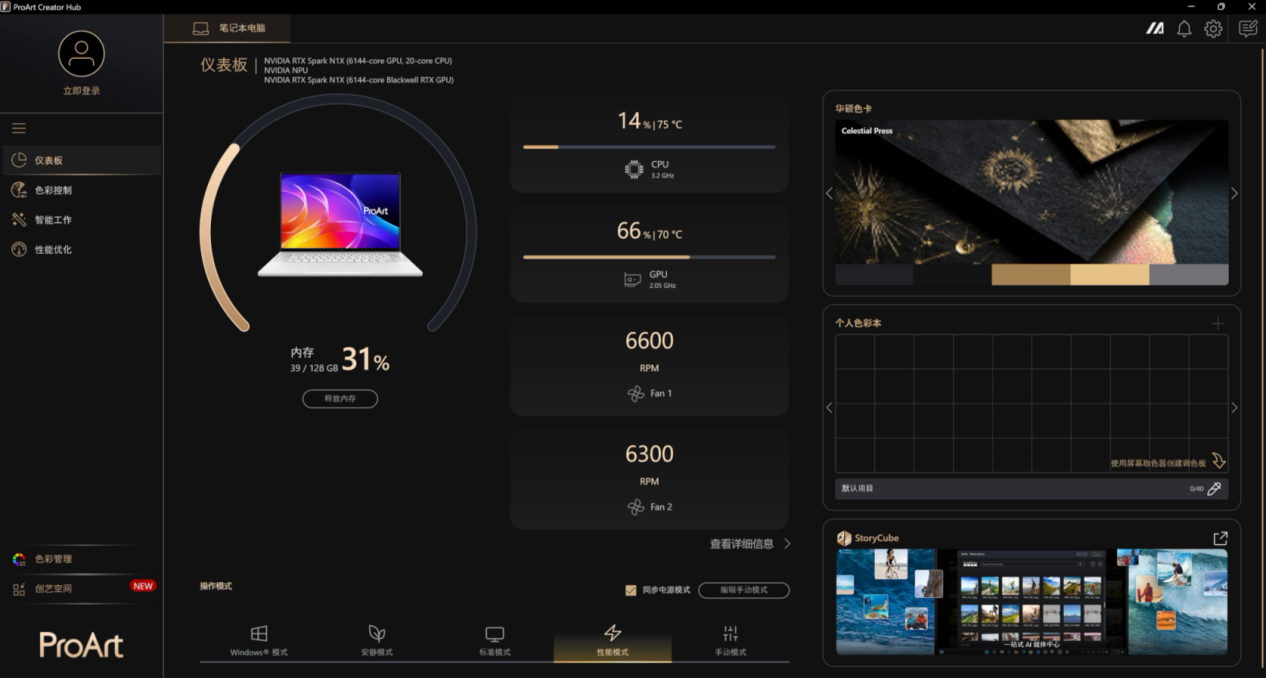
在ProArt Creative Hub中设置性能模式
我们将华硕ProArt 创16 RTX Spark设置为“性能模式”,确保它在测试中发挥出全部性能。内存/显存则使用64GB+64GB的分配模式,提供更广泛的模型适配能力。
很明显,华硕ProArt 创16 RTX Spark是专为端侧AI智能体应用、开发和专业设计打造的,它最大的用途就是在端侧跑AI,为用户提供可靠的隐私安全性和节约云端Token费用,实现随时随地可用的智能体应用解决方案。因此,我们的测试项目也以本地加载运行AI模型、AIGC等应用为主,同时也兼顾一些RTX技术升级带来的专业设计功能体验与游戏体验,旨在为大家全面展现华硕ProArt 创16 RTX Spark的各方面能力。
AgentPerf基准测试
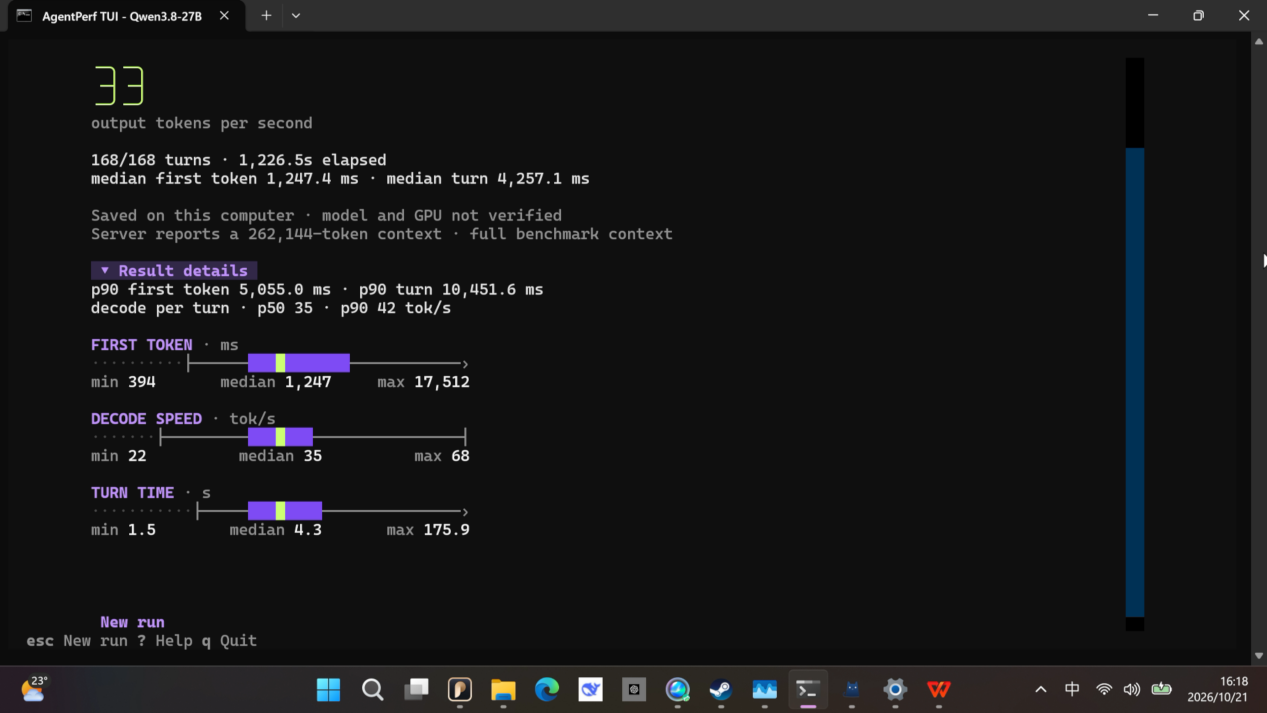
AgentPerf测试得分
AgentPerf Local 是 Artificial Analysis 推出的新基准测试,把它广为人知的 AgentPerf 基准扩展到了本地系统。它通过从真实运行的Agent录制得到的traces(轨迹)来还原真实的
agentic使用场景,该基准包含由Agent解决SWE-bench和PinchBench问题所产生的录制数据。这里我们使用Llama.cpp部署Qwen3.8-27B-Q3-K-M MTP模型进行测试。默认基准测试会依次跑完来自两个基准的8个独立任务,共计168轮,因此也是168条独立的prompt,总计约2.5M输入Token和约31k输出Token。
从测试结果来看,RTX Spark N1X总耗时1226.5秒,平均速度为33 tokens/s,这个表现符合预期。实际上,在本地运行参数量高达27B的Qwen3.8模型且上下文极大的情况下,超过30 tokens/s的速度已经保证了非常流畅的文本生成体验。首字延迟部分,RTX Spark N1X成绩为1247.4ms,可以说基本感觉不到明显的顿挫。回合时间方面,成绩为4357.1ms,表示每轮交互(包含模型理解、工具调用、生成回复)的中位耗时约为 4.3秒。考虑到这是一次完整的168轮深度交互测试,平均每轮4.3秒的综合耗时是一个非常扎实的成绩。这表明10 个Cortex-X925性能核在进行任务调度与工具调用的同时,并未对GPU推理造成严重的抢占和瓶颈。
总的来说,拥有128GB统一内存的华硕ProArt 创16 RTX Spark采用64GB内存/64GB显存的分配模式,将27B参数模型、超长上下文窗口以及系统进程完全置于了本地。这种设计彻底打破了传统“显存不够就无法加载模型”的桎梏,让RTX Spark N1X拥有了媲美小型数据中心的本地AI吞吐能力。
SpeedBench基准测试
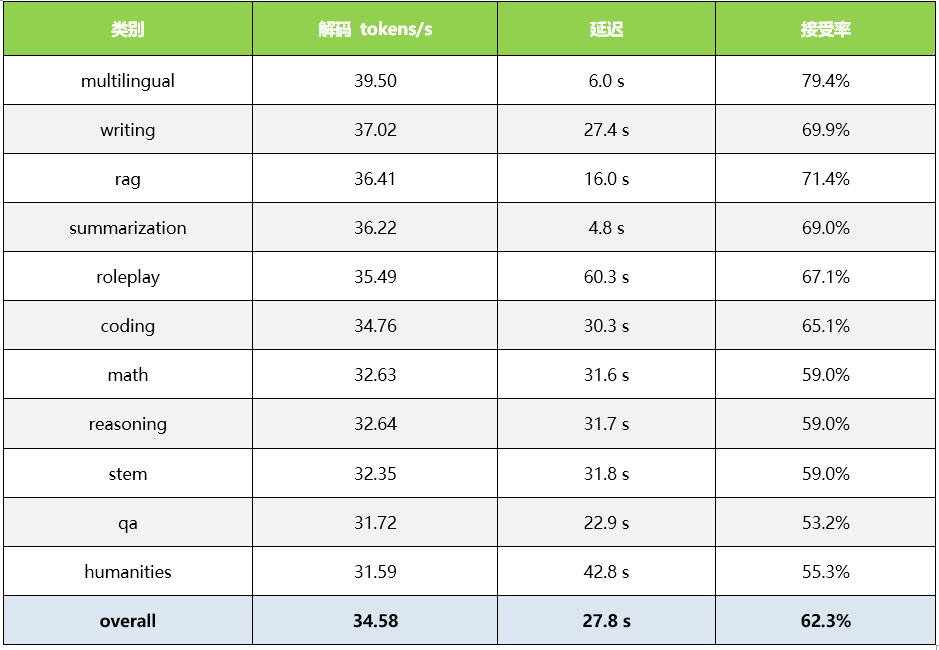
SpeedBench是一个使用真实数据集和MTP(Multi-Token Prediction,多Token预测)来测量模型解码速度的基准测试。截至2026年,相比传统基准,它采用覆盖代码、问答、多语言等多个类别的真实数据,更贴近模型实际使用时的性能表现。SpeedBench用一个覆盖多个类别(Coding、Q&A、Multilingual等)的数据集,能反映模型实际使用时的真实体验。
从测试成绩来看,综合平均解码速度接近35 tokens/s,这说明RTX Spark N1X在llama.cpp的优化下,持续的文字生成速度确实可以稳定在30+ tokens/s,这对于端侧笔记本来讲是一个很舒适的体验。
仔细观察各项数据,还可以发现,即使在逻辑推理(reasoning、math、stem)这种对计算要求最高的场景下,解码速度依然能维持在31 tokens/s~32 tokens/s,没有出现断崖式下跌,这充分说明64GB的GPU显存分配在Llama.cpp 中得到了充分利用,大参数量模型的权重和推理计算完全由强大的Blackwell GPU在负责。
MLPerf Client 2.0.1基准测试
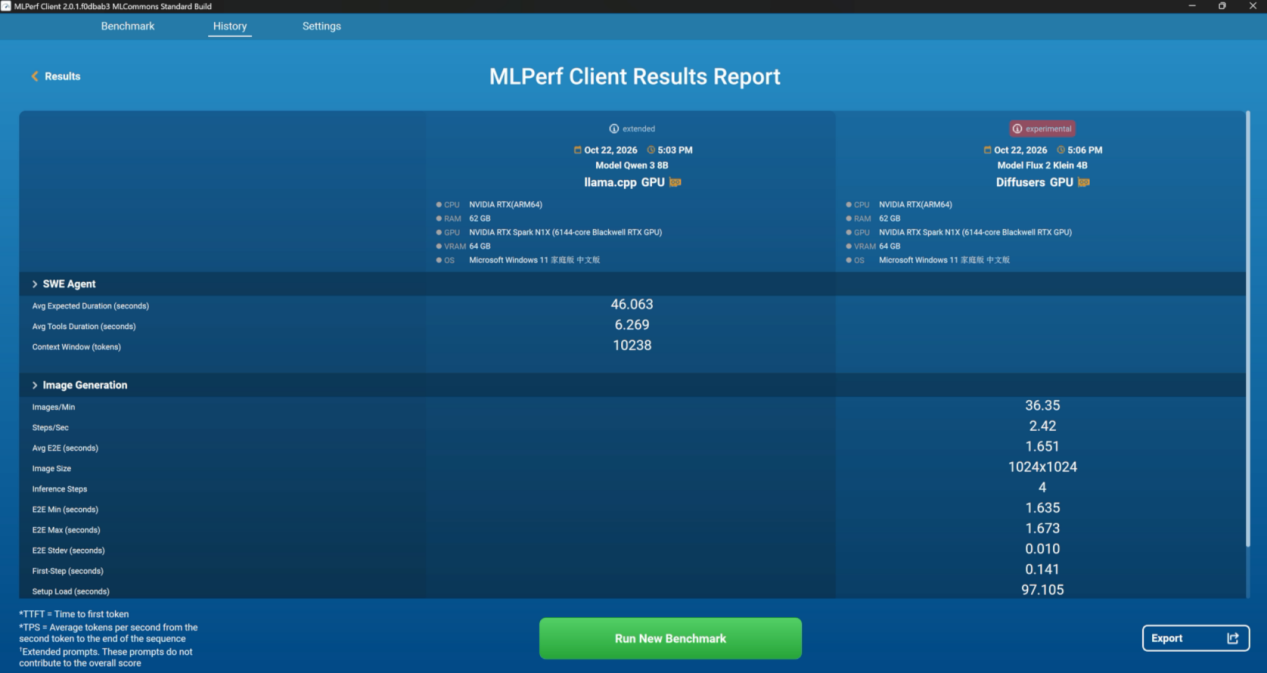
MLPerf Client 2.0.1测试得分
MLPerf Client 2.0.1是由MLCommons协作开发的免费开源基准,用于评估个人电脑上的 LLM 推理、Agentic以及图像生成性能。在2.0及以上版本中,MLPerf Client 新增了两项测试:一项Agentic测试和一项FLUX.2 Klein图像生成测试。这两项测试使该基准在当今环境下极具现实意义,也与终端用户高度相关;Image Generation测试使用Flux2.Klein-4b,这是当前使用最广泛、质量最高的图像生成模型之一。Agentic测试模拟一个简短的Agentic循环,就像在现代Agentic harness(如OpenClaw或Hermes)实际使用一样。测试中,Agentic项目使用Qwen3 8B模型,而图像生成使用Flux 2 Klein 4B模型。
SWE Agent测试部分,MLPerf在测试中运行了 Qwen3 8B 模型,对于传统的消费级显卡而言,在Windows本地跑 SWE Agent这种长上下文推理简直是“内存灾难”,但在RTX Spark上却表现得游刃有余,测试的上下文窗口达到了 10238 Tokens。这说明超大的统一内存,不仅轻松塞入了模型权重,还为极其庞大的上下文KV Cache 留下了极其宽裕的空间。此外,平均工具调用耗时仅 6.2秒。SWE Agent需要不断在代码库中检索、调用API并分析反馈,这意味着20核Arm CPU在进行系统级调度时,与Blackwell GPU之间保持了极高的通信效率,没有因为庞大的上下文导致严重的调度阻塞。
图像生成部分,MLPerf采用了 FLUX.2 Klein 4B 模型,并设定了 1024×1024 的高分辨率,而在这样的高清分辨率下,RTX Spark N1X依然能保持每分钟36张左右的输出速度,这意味着生成单张图片仅需1.6秒左右。此外, EZT(End-to-End Time)代表了从按下生成到最终看到完整图片的时间,而1.65秒的延迟,加上仅0.141秒的首步耗时,说明RTX Spark N1X完全具备本地运行“AI修图助手”或“实时设计迭代”的能力,彻底告别了传统生图软件动辄几秒甚至十几秒的等待。
LMStudio测试
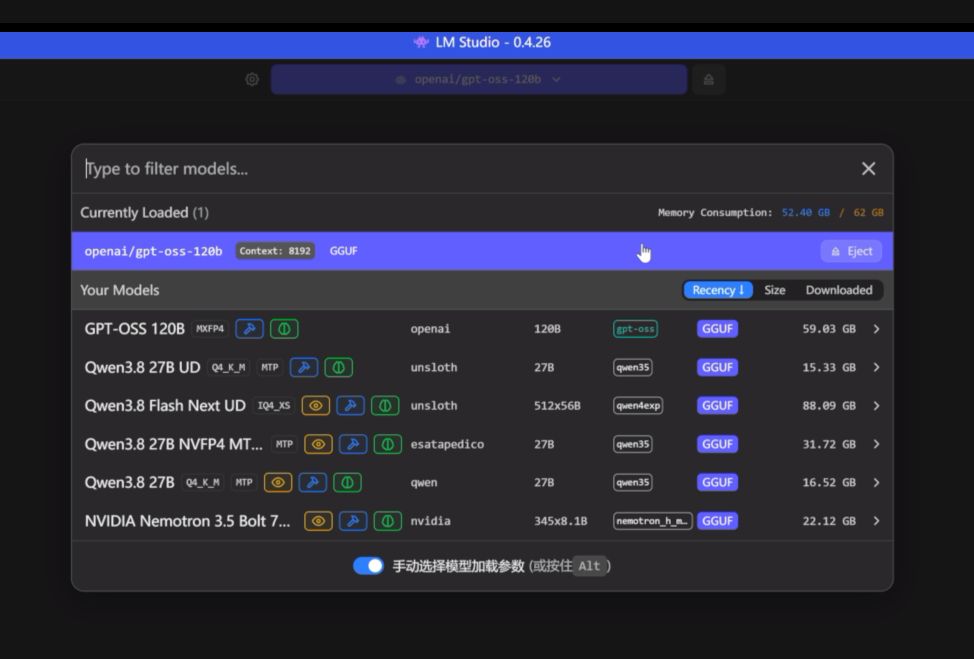
LMStudio中加载120B超大模型
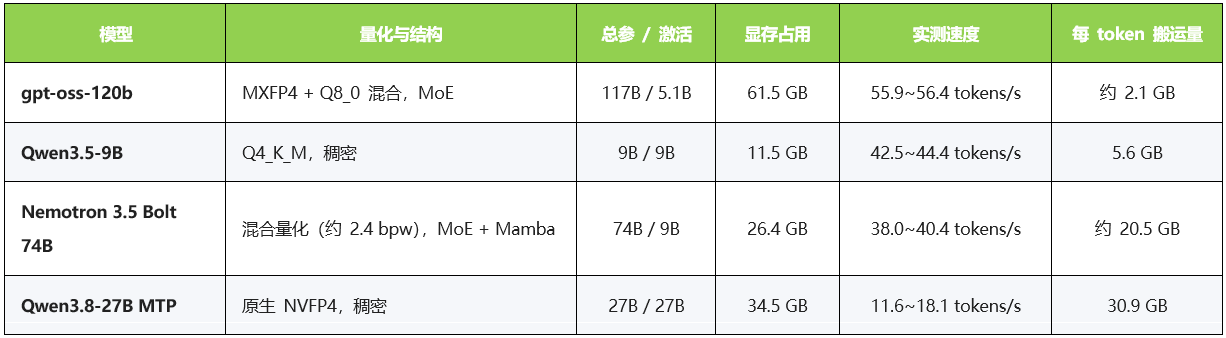
LMStudio这边我们用RTX Spark N1X生成1000字的文字内容来测试本地运行不同大模型的效率。运行时方面选择了CUDA 13 Arm64 2.65版,确保提供最好的兼容性和效率。可以看到,RTX Spark N1X的表现十分抢眼,gpt-oss-120b的实测速度甚至超过了55 tokens/s,效率相当不错。
把4组数据换算成“每秒有效读取的权重量”,结果接近平台的标称带宽。解码阶段的耗时几乎全部用于把权重从显存搬进计算单元,因此决定速度的是每生成一个token需要搬运多少字节,而不是模型有多少参数。这直接解释了gpt-oss-120b(约56 tokens/s)比 9B稠密模型(约43 tokens/s)更快的情况。前者每token只有5.1B参数参与计算,MXFP4下约2.1 GB 数据;后者则要全量搬运5.6 GB。
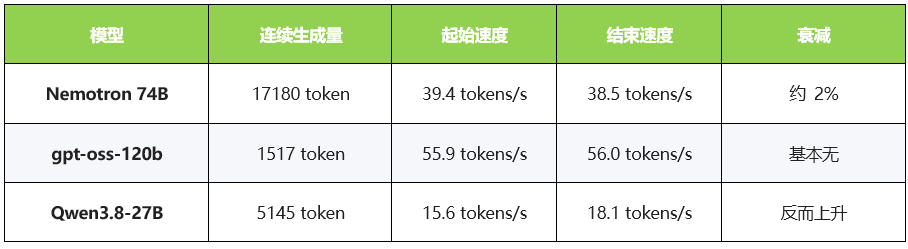
此外,Nemotron模型连续输出1.7万token后速度只衰减了大约2%且趋于平稳。这是Mamba混合架构的先天优势:绝大多数层不带KV缓存增长,上下文再长也不会像纯Transformer那样逐步变慢。27B模型的前低后高则是权重预热与缓存命中的结果,属于正常波动。其实对 Agent类工作负载(几千到几万token的长输出、多轮累积上下文),这三个模型都不会出现越写越慢的问题。
总的来说,40 tokens/s 跑74B MoE、56 tokens/s 跑120B,这个表现其实对于笔记本来讲非常出色了。首先,消费旗舰独显的24 GB显存根本装不下这两个模型;其次,RTX Spark的价值不在峰值速度,而在于能用超大的统一内存把120B级别的模型完整装进显存运行,这是消费级显卡做不到、公有云API又无法提供的本地私有能力。
本地文生图体验
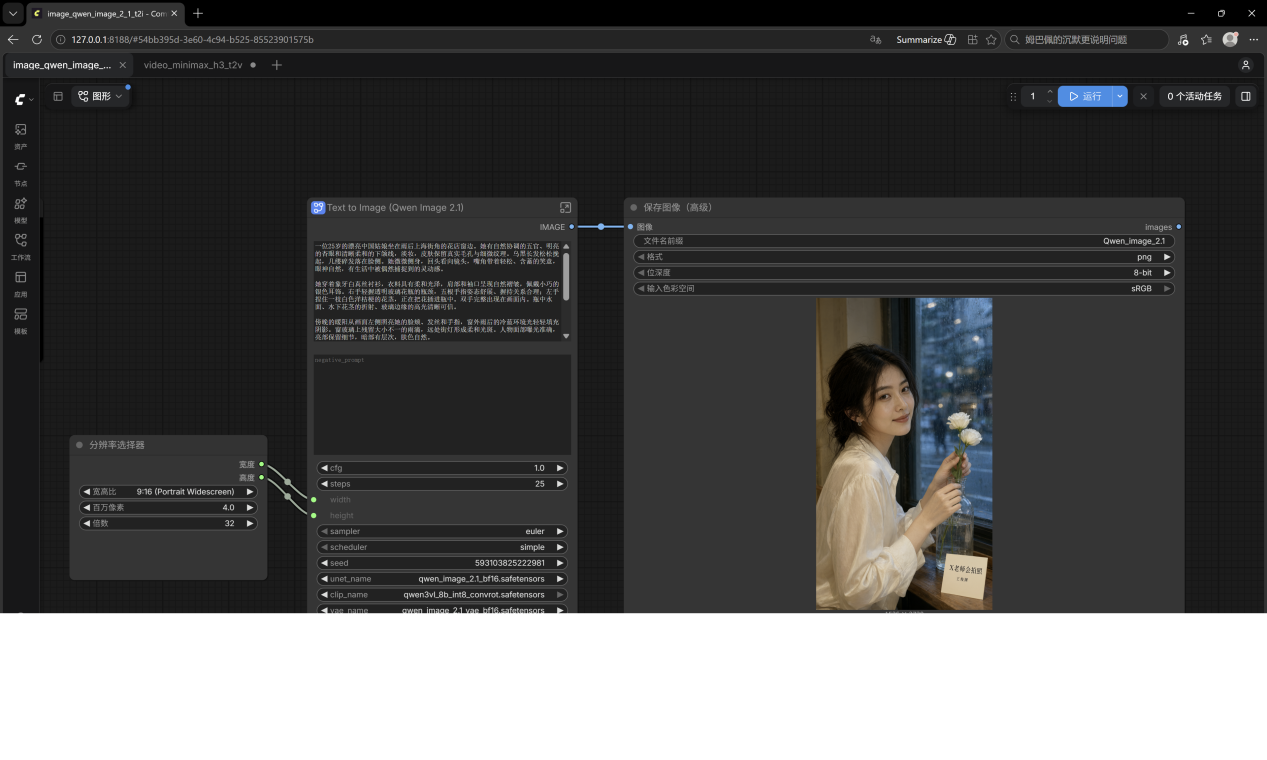
使用qwen image_2.1 bf16模型文生图
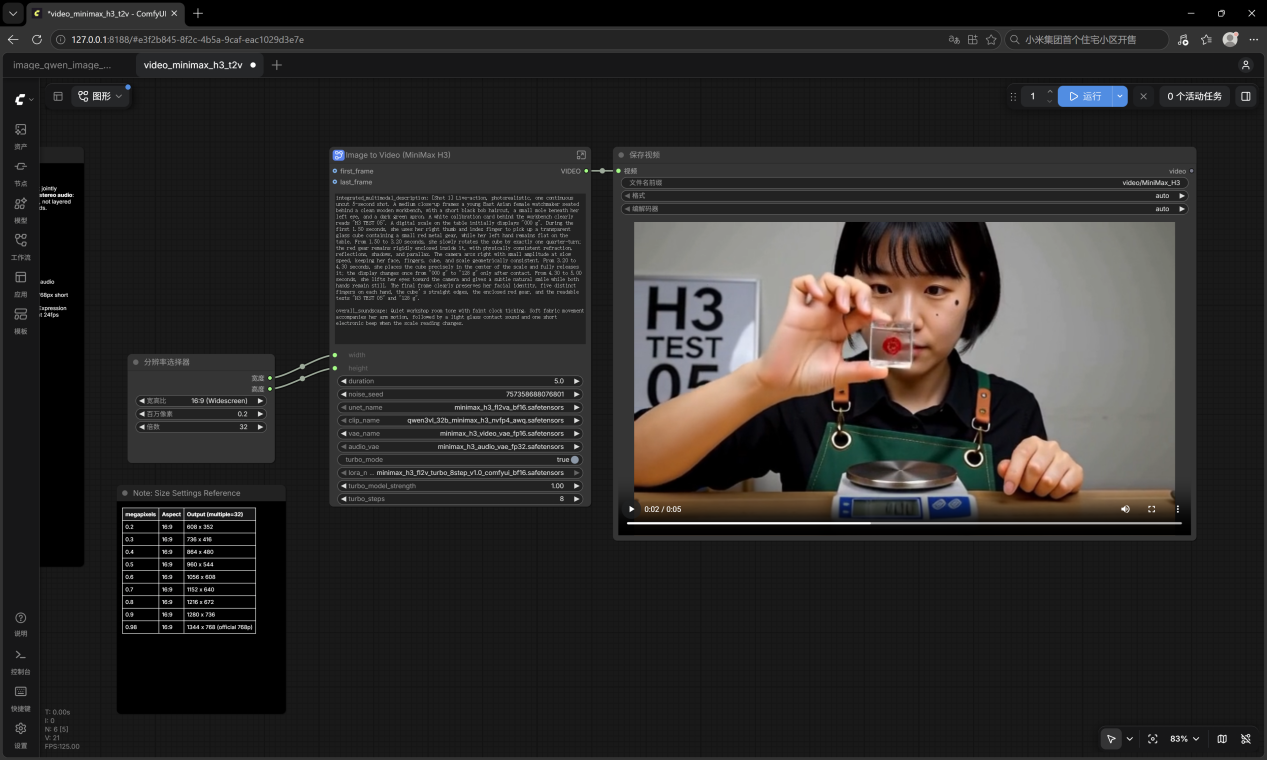
使用Minimaxh3_fl2va_bf16模型文生视频
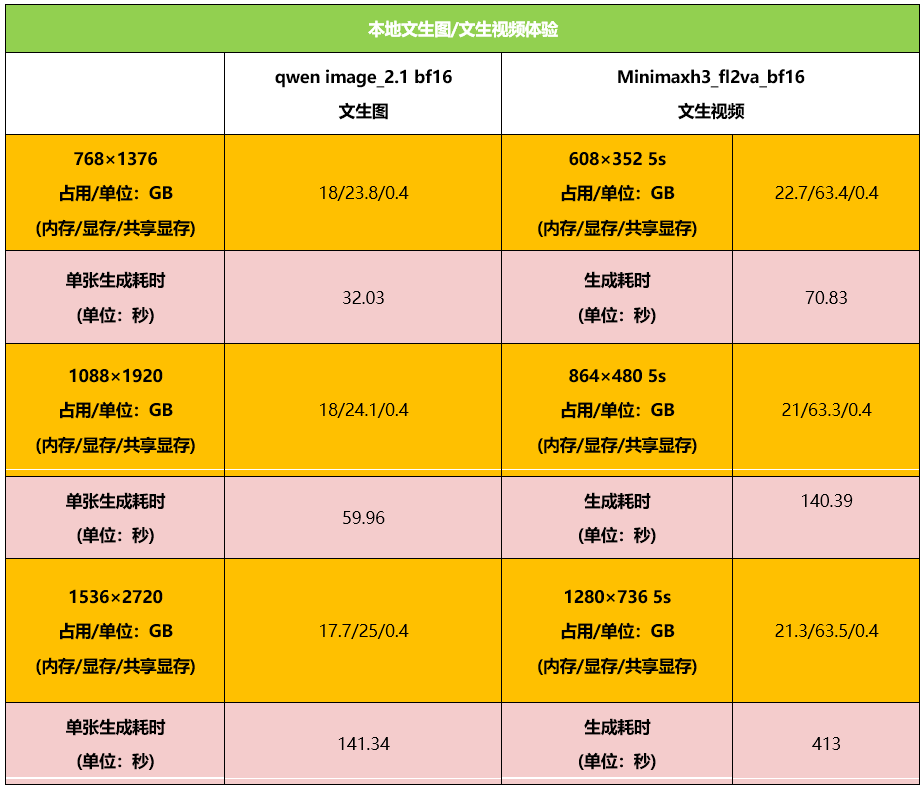
文生图方面,我们使用comfyUI官方原生 Windows ARM64 便携版进行体验。使用的模型为qwen_image_2.1bf16官方文生图工作流,固定提示词,随机种子,文本编码器,vae编码器,测试中记录不同尺寸单张图片生成时长。可以看到,在图片生成场景下,运行未量化、未剪枝,满血版qwen_image_2.1bf16模型时,2K图片生成大约占用25GB显存。
在 ComfyUI这种底层工作流中,使用未经量化、未剪枝的满血版 bf16 模型进行本地推理,对硬件的算力、显存和内存带宽都是很严苛的考验。在文生图测试中,最抢眼的不是生成速度,而是极其稳定的显存分配。在所有分辨率下,GPU显存都稳定在25GB左右,完美避开了系统共享内存的介入。这意味着GPU能够利用统一内存带宽全速进行矩阵运算,没有受到内存带宽的拖累。
此外,单张1536×2720的2K分辨率图片生成耗时 141.34秒。在传统16GB或24GB显存的消费级显卡上,运行满血 bf16 模型几乎无法触及这个分辨率。但RTX Spark N1X超大统一内存的设计显然可以轻松驾驭,让设计师可以在2K高分辨率下进行创意迭代。
文生视频方面,我们使用Minimaxh3_fl2va_bf16模型和Comfyui官方MinimaxH3文生视频工作流,固定提示词、时长5s、种子、文本编码器、vae编码器、lora强度、turbo8步采样,记录不同尺寸视频生成的时长。可以看到,生成608×352/5秒的视频耗时约70秒、864×480/5秒视频耗时约140秒、1280×736/5秒视频耗时约7分钟,对于端侧设备来讲实用性也足够了。尽管视频生成是 CPU、GPU 以及内存带宽的“三方合作”,但ComfyUI工作流能够如此稳定地在本地跑完413秒的长负载,证明Blackwell GPU 与20核Arm CPU之间的数据互通是十分流畅的。
此外,ComfyUI也正在发布用于任意视频工作流程的新节点,这些节点可提升像素分辨率、插值生成新帧,并实现映射到高动态范围的色调映射。这意味着创作者可以缩短迭代时间,并交付超出模型自身能力的分辨率、帧率与HDR效果。RTX Video Super Resolution也更新到了最新模型,新增流式模式、去噪、去模糊、高码率模式以及可调的模型强度。RTX Video Frame Generation提供全新节点,利用Tensor Cores实现AI帧插值,将视频帧率翻倍、增至三倍或四倍。而RTX Video HDR的全新节点可实时将SDR视频转换为HDR,同时对比度、饱和度可调,亮度最高可达约2000 nits。
综合来看,在RTX Spark N1X加持下,本地AI不再只是玩票或跑跑量化模型。 拥有128GB统一内存和Blackwell GPU的情况下,设计师可以像使用本地应用一样在本地运行AI生图/生视频工作流,而对于追求素材绝对隐私、摆脱云端API限制和token消耗的专业创作者来讲,RTX Spark N1X确实是一个出色的解决方案。
小硕 × WorkBuddy体验
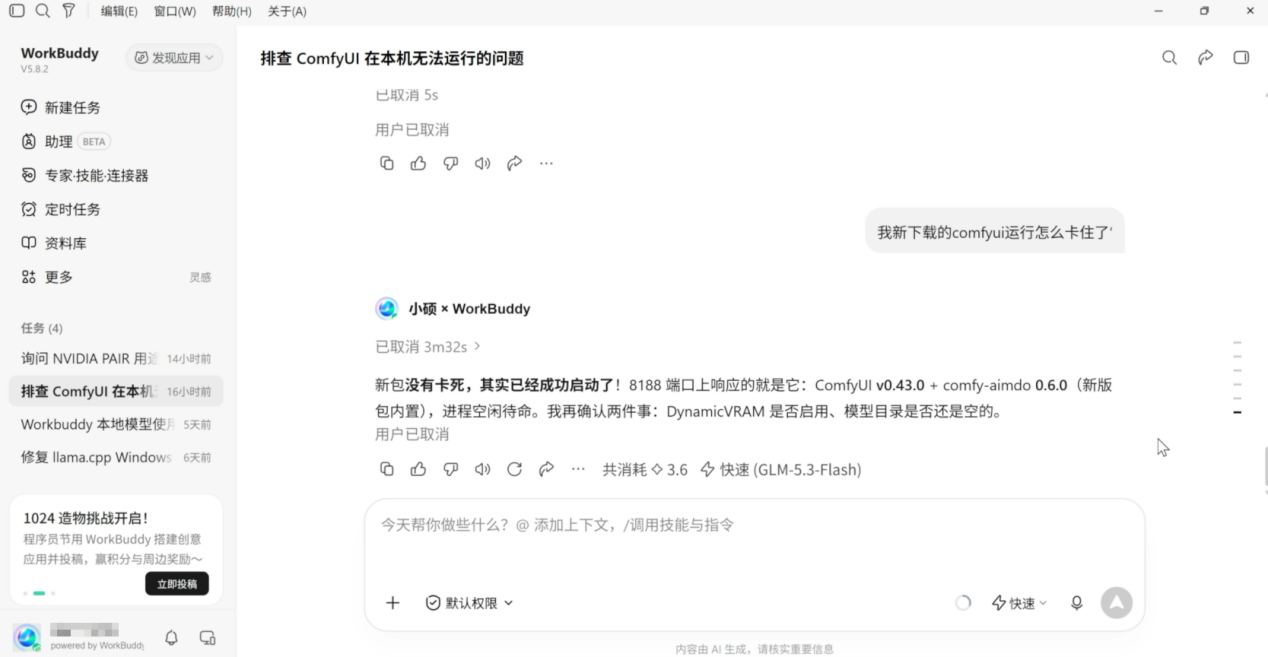
体验使用“小硕 × WorkBuddy”完成各种AI应用调试
华硕ProArt 创16 RTX Spark内置了专属定制版“小硕 × WorkBuddy”,除了它本身的强大功能之外,而在这台“Windows on Arm”的笔记本上,它对于RTX Spark的适配也做得很好,实际上在整个测试过程中,它都能帮我们解决各种问题,帮我们免去了很多麻烦。简单举例,可能对于很多新手朋友来讲,配置各种AI智能体、运行环境是一件很难上手的事,但是只要给“小硕 × WorkBuddy”说一声,它就帮你一条龙搞定。从这一点来讲,有“小硕 × WorkBuddy”加持的华硕ProArt 创16 RTX Spark,除了能帮老手事半功倍之外,也能让新手快速入门,迅速与AI智能体时代实现同步。此外,“小硕 × WorkBuddy”也支持使用本地模型,如果不会配置,也可以让它自己下载模型并加载使用,仅需一句话即可。这对于有更高隐私安全需求的用户来讲,也是非常实用的设计。
生产力增强功能与基准性能
Blender Windows ARM64版DLSS降噪体验
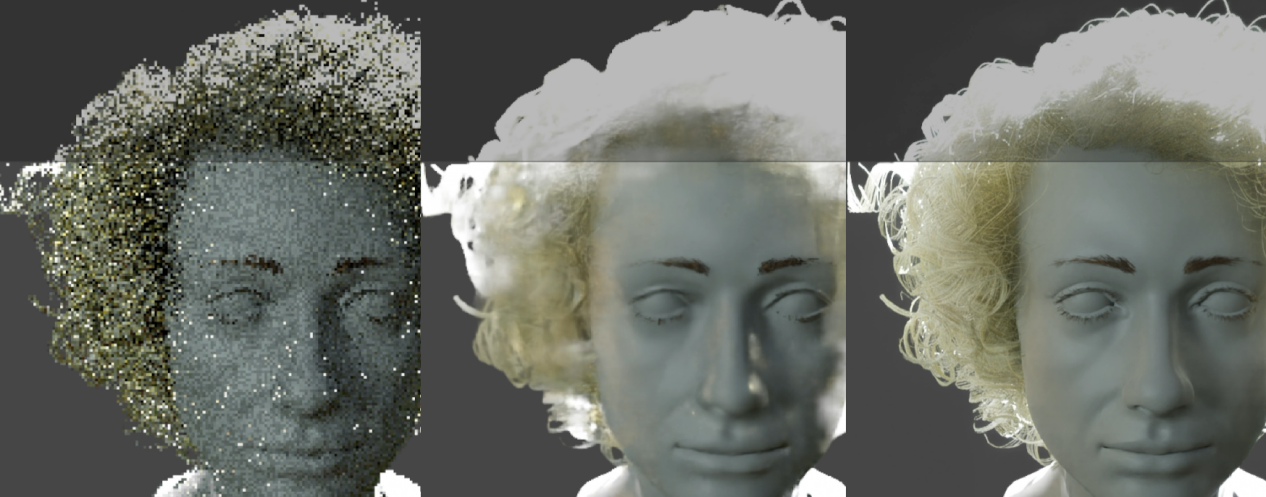
HairStyles场景,从左到右依次是“无降噪”、“Optix降噪”、“DLSS降噪(质量)”,改变光照观察画面变化
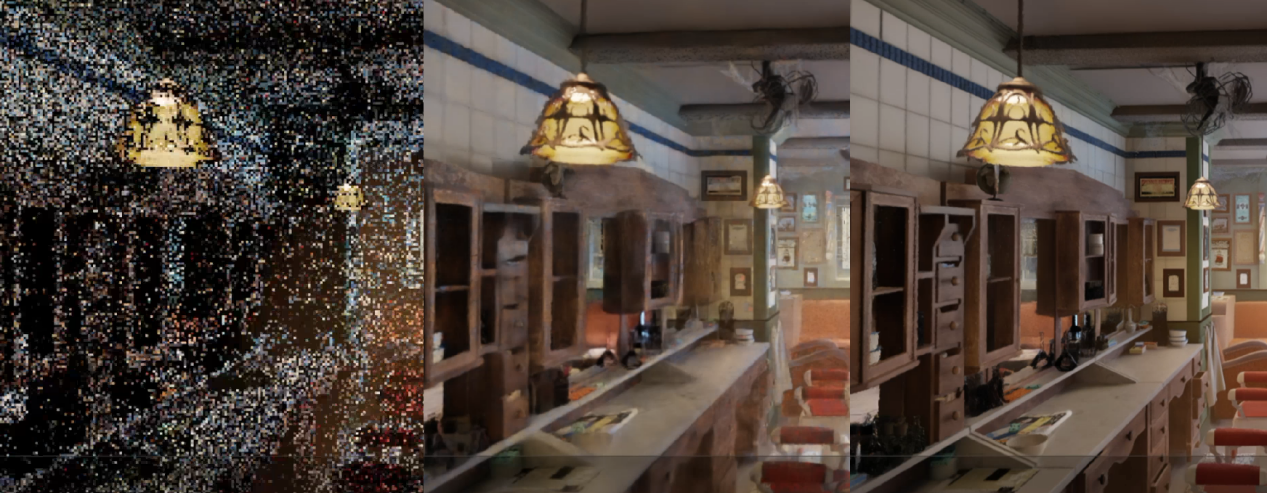
Barbershop场景,从左到右依次是“无降噪”、“Optix降噪”、“DLSS降噪(质量)”,在场景中移动观察画面变化
Blender 5.3.0 Alpha及以上的测试版已经提供了对DLSS 4.5 Ray Reconstruction的支持,这里我们下载对应RTX Spark的Windows ARM64版进行体验。这里我们在两个场景下比较“无降噪”、“Optix降噪”、“DLSS降噪(质量)”三种设置下的渲染视图效果。其中HairStyles 场景展示了DLSS降噪在Blender的交互式编辑中带来的视觉提升,而Barbershop场景展示了DLSS降噪在穿行于精细室内场景时保持渲染视图清晰。在实际体验中可以明显感觉到开启DLSS降噪后,不但在改变光照条件、动态预览的环境下图像细节更加清晰,同时在光照变化/运动结束后,画面恢复清晰的速度极快,这对于创作者来说更有助于比较各种改动方案,减少等待画面稳定的时间,节约更多时间出来打磨场景,提高工作效率,这也是NVIDIA RTX生态在生产力应用方面独有的优势。
Cinebench测试
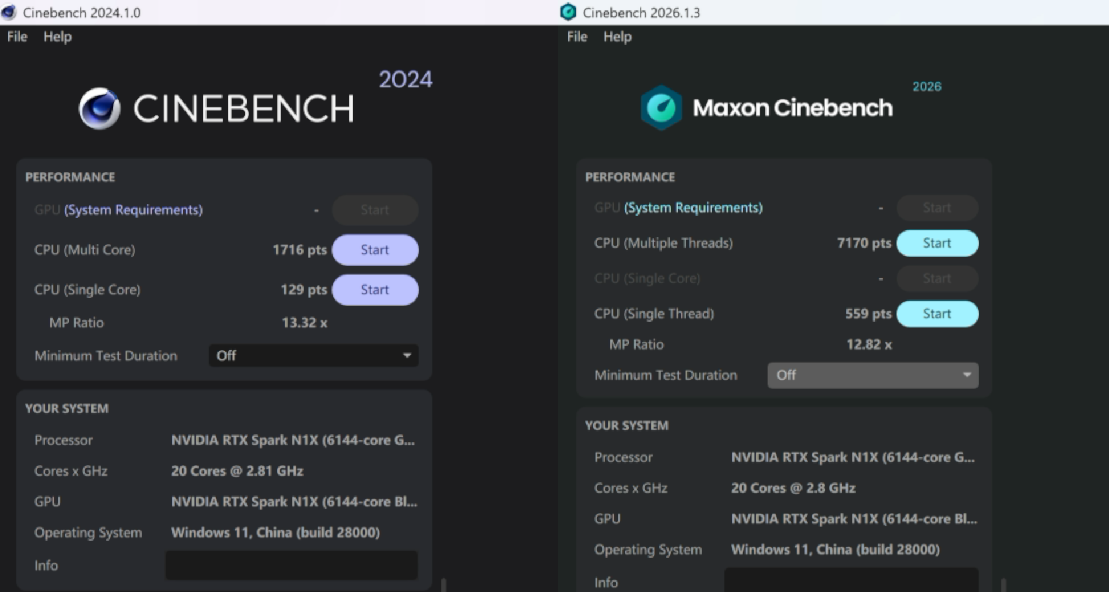
Cinebench Arm64版测试
Cinebench也提供了Arm64版的测试工具,这里我们也使用Cinebench 2024/2026简单测试了一下,看看RTX Spark N1X的实际表现。从成绩可以看到,拥有20核20线程的RTX Spark N1X的处理器多线程性能与当前中高端X86处理器相当,而单核性能则达到了X86旗舰级处理器的水平。
V-Ray Benchmark测试
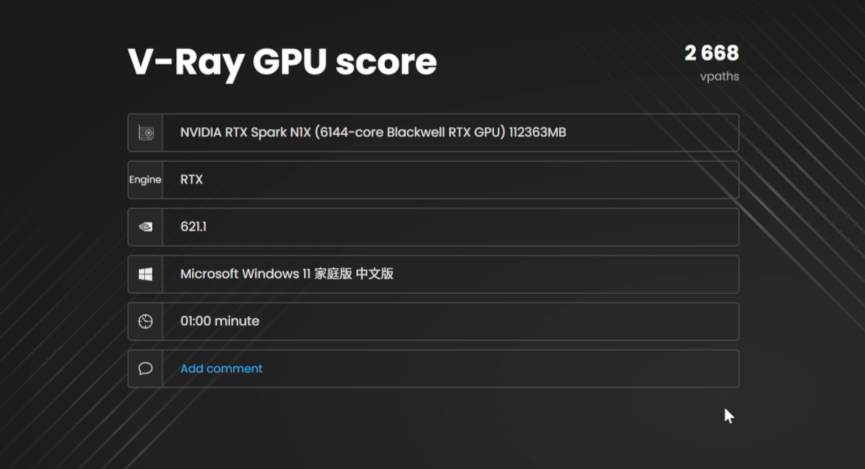
V-Ray Benchmark Arm64版(GPU RTX)测试
V-Ray渲染器的Benchmark也有Arm64版,这里我们对RTX Spark N1X的GPU部分进行渲染测试,采用RTX引擎。可以看到,2668分的成绩与当下主流移动独显相比也毫不逊色。
NVIDIA Broadcast体验
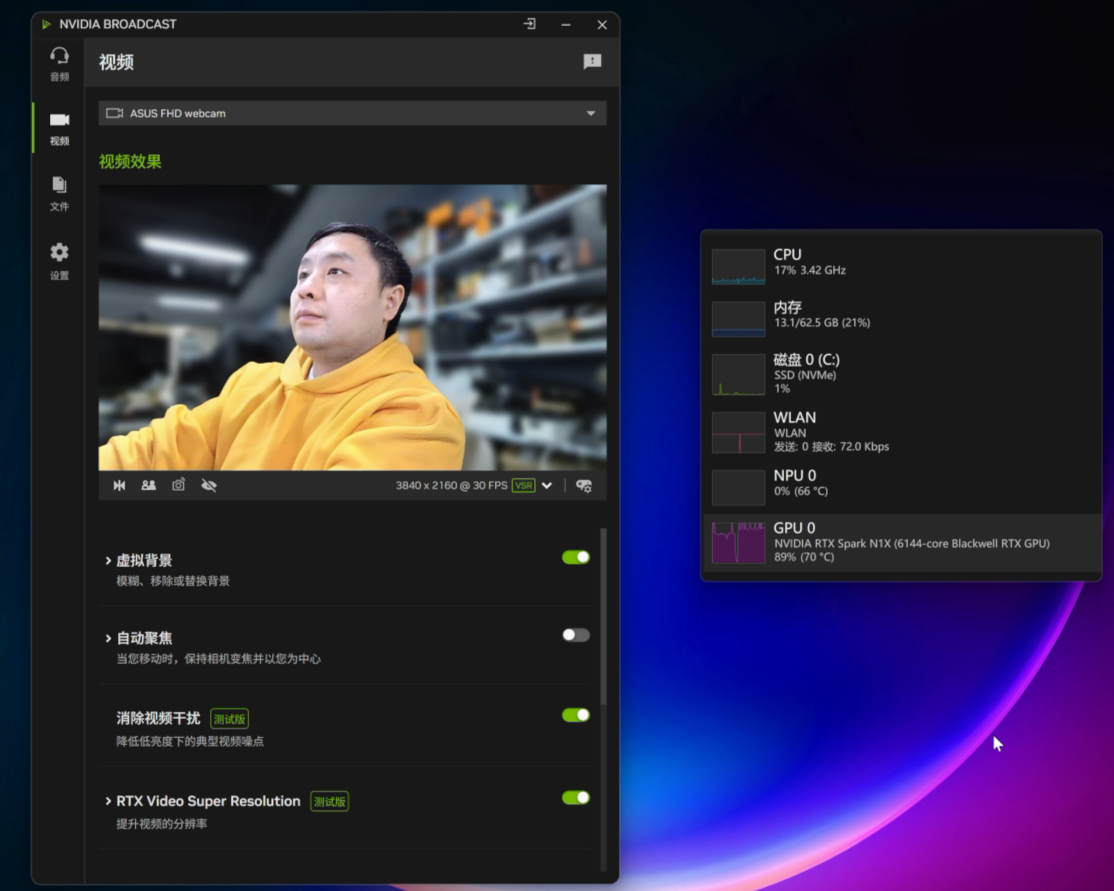
NVIDIA Broadcast效果体验
RTX Spark拥有专属的Windows on Arm版NVIDIA Broadcast。NVIDIA Broadcast可以使用AI特效,让用户在视频通话和直播中呈现最佳的形象与声音;这个版本新增了对已录制媒体文件的处理以及 Agentic(智能体)控制。用户现在可以直接对已录制的文件应用音频和视频效果,无需第三方编辑工具。RTX 视频帧生成(Beta)可将摄像头帧率在直播模式下提升至最高60 fps,为通话和直播产出更流畅的画面。RTX视频超级分辨率(Beta)可减少压缩伪影,并将摄像头或文件视频放大至最高4K分辨率,让低分辨率摄像硬件输出的画面更锐利、细节更丰富。Studio Voice麦克风配置文件新增三种语音预设:Bright(明亮)、Full(饱满)和 Warm(温暖),用于塑造麦克风音色。AI Agent(MCP 服务器)允许兼容的本地AI Agent 通过Model Context Protocol以编程方式读取和修改受支持的NVIDIA Broadcast设置。Agent 可以开关特效、调整参数,并向文件处理器提交文件。从截图可以看到,开启RTX Video Super Resolution(视频超级分辨率)之后,原本摄像头提供的1080P视频就变成了4K分辨率,清晰度大幅增加,同时虚拟背景也起到了突出主体的作用。而且在资源管理器里也可以看到,这一切都是通过NVIDIA RTX Spark N1X的GPU在进行计算。
游戏体验:流畅运行热门大作
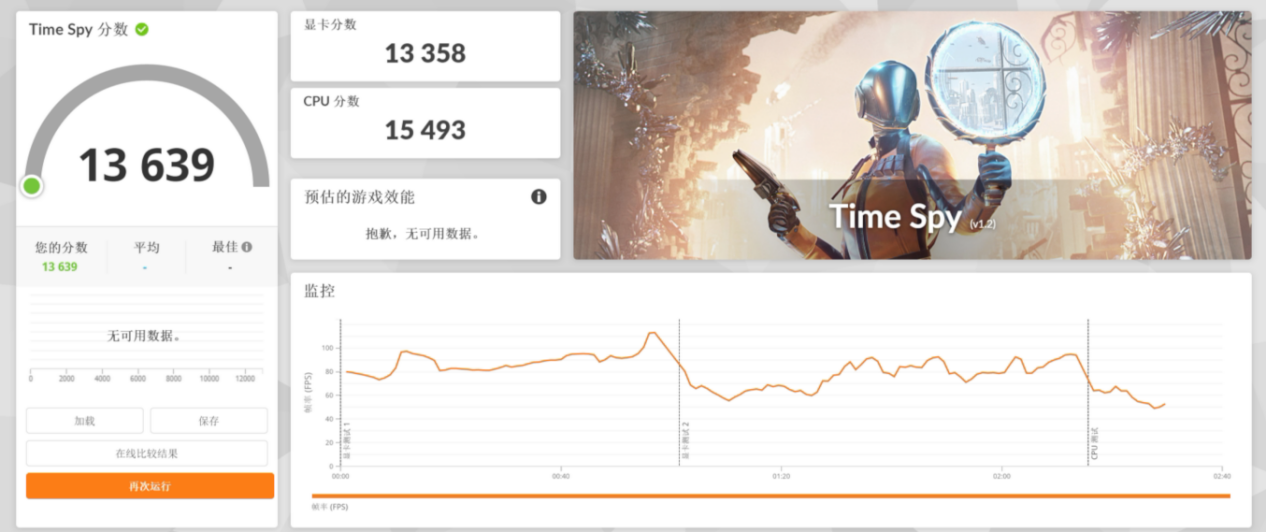
TimeSpy GPU得分高达13358,与RTX 5070 Mobile版持平
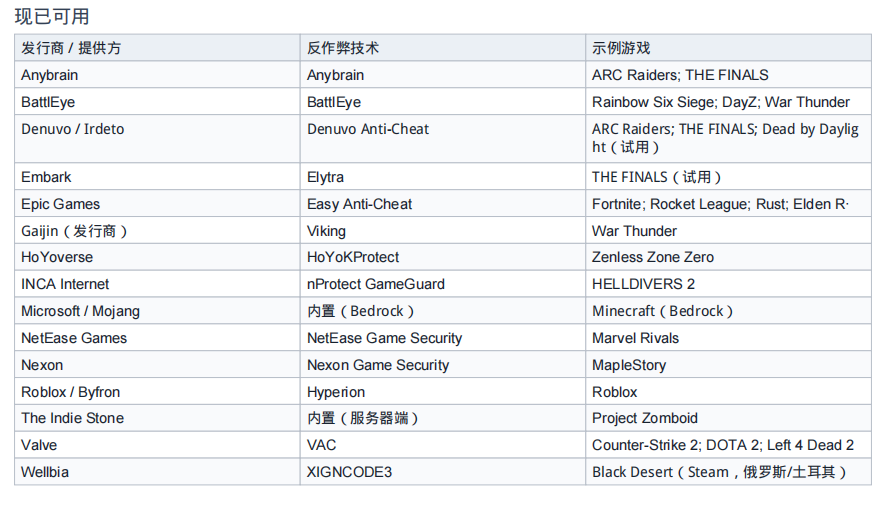
RTX Spark已经对很多主流反作弊插件提供了兼容
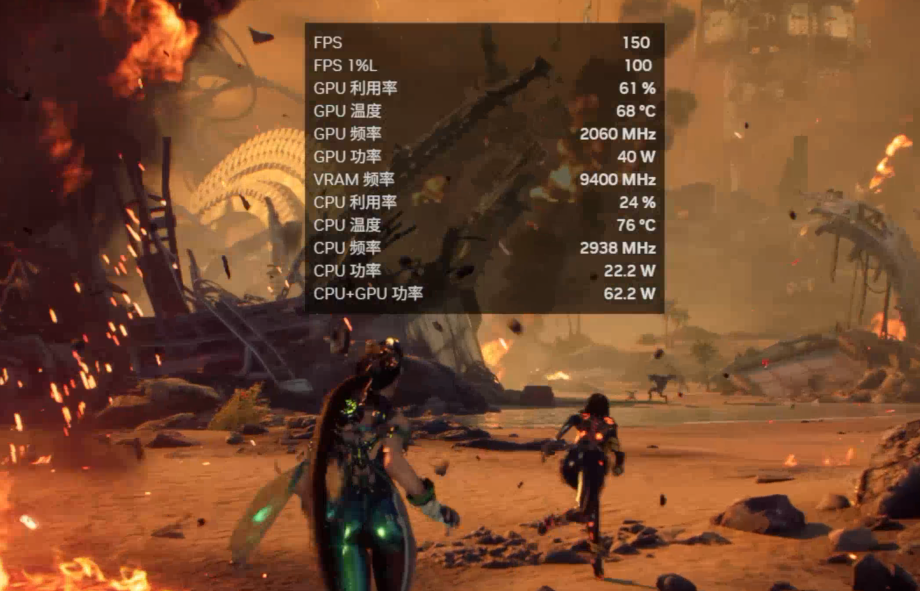
游戏中RTX Spark N1X的CPU+GPU总功率基本上都在60W出头
虽说华硕ProArt 创16 RTX Spark是一款创作本,但RTX Spark N1X内置的Blackwell GPU性能十分强大,3D Mark TimeSpy GPU得分与RTX 5070 Mobile持平,而且支持RTX 50系全套特性,在游戏中一样可以享受光追/路径追踪、DLSS4.5/5之类黑科技带来的出色游戏体验。当然,超大统一内存也让它在现有游戏环境下有效规避了独显容易爆显存的问题。
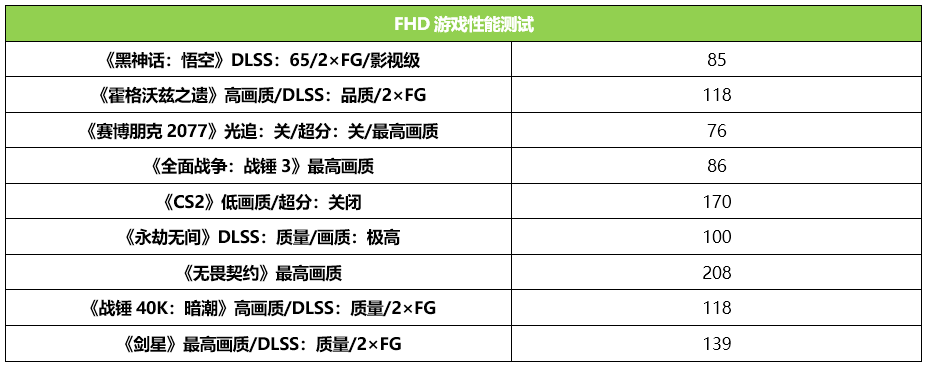
从游戏实际体验来看,用华硕ProArt 创16 RTX Spark完全可以在高画质下获得流畅的“百帧”游戏体验,在工作之余也可以轻松享受游戏大作。这里值得注意的是,在没有提供Arm64版的游戏中,游戏通过Windows的Prism转译运行,对于比较吃CPU的游戏(特别是电竞网游)来讲,会有一定的性能损失,而GPU则不受此影响,所以在3A类游戏中,即便是跑在Prism上,帧率影响也非常小。此外,对于大家关心的反作弊插件兼容问题,实际上RTX Spark已经对很多主流反作弊插件提供了兼容,其他的一些反作弊插件也会在后续陆续提供支持,玩家可以放心了。
游戏功耗方面,玩游戏时,RTX Spark N1X的CPU+GPU总功率基本上都在60W出头,少数没有Arm64版只能跑Prism转译且比较吃CPU的游戏总功率会更低。另外,我们可以看到设计极度轻薄的华硕ProArt 创16 RTX Spark的散热依然控制得很好,玩游戏的时候CPU温度不到80℃,GPU也不到70℃。考虑到RTX Spark N1X的游戏功率控制出色,笔记本又搭载了99.9Wh的大电池,那么在不插电的情况下,玩家也可以满帧持续畅玩更久的时间。
功率与散热测试
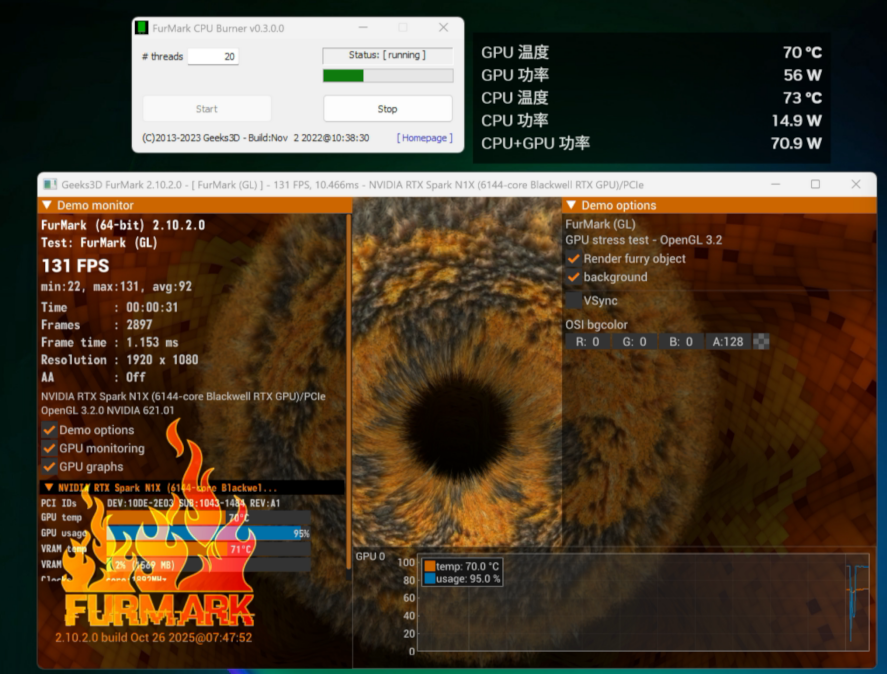
CPU+GPU双考,总持续功率大约为70W~73W
在性能模式下使用FurMark双考,CPU+GPU总持续功率大约在70W~73W水平,SOC的总功耗约为80W。CPU此时大约分配到15W,温度保持在73℃左右,GPU大约分配到56W,温度大约在70℃水平。单考CPU,CPU峰值功率可到88W左右,持续功率也是保持在70W~73W水平,温度大约88℃。单考GPU,持续功率也差不多70W水平,温度保持在73℃左右。其实RTX Spark N1X这个能效表现相当惊人了,以 SOC总功率80W的水平,提供了相当于200W功率X86高性能本的性能级别,再加上华硕ProArt 创16 RTX Spark出色的散热设计,将温度也控制得比较好,使用体验确实相对传统X86高性能本有明显优势。
总结:NVIDIA的跨时代创新,AI智能体时代必备利器
最后来简单总结一下。
首先是NVIDIA RTX Spark N1X在架构上的创新,它用NVLink-C2C的600GB/s片内互连带宽,把20核Grace CPU与Blackwell GPU耦合成硬件级的缓存一致性系统,因此可以共享最高 128GB的LPDDR5X 9400MT/s统一内存(显存最高可手动分配至96GB),FP4算力高达1 Petaflop。配合3nm工艺、45W~80W可调TDP,加上与计算卡、RTX PRO、DGX完全一致的CUDA生态,让专业创作、AI 智能体与RTX游戏应用首次被整合进同一颗移动SoC。
然后是NVIDIA开创的端侧AI时代:容量决定“能不能跑”,带宽决定“跑多快”。NVIDIA RTX Spark N1X的128GB统一内存彻底拆掉了“显存不够就加载不了”的桎梏。从测试可以看到,AgentPerf Local跑Qwen3.8-27B,168轮、约250万输入token、平均速度33 tokens/s,首字延迟1247.4ms、回合4357.1ms;SpeedBench综合速度34.58 tokens/s,最吃算力的 reasoning/math/stem也稳在32 tokens/s上下,没有断崖式下跌;MLPerf Client的SWE Agent 把上下文拉到10238 tokens、平均工具调用仅6.2秒;FLUX.2 Klein 4B在1024×1024分辨率下每分钟出图约36张、端到端延迟仅1.65秒、首步耗时仅0.141秒,可见RTX Spark N1X已具备本地“实时设计迭代”能力。
另外,LMStudio的数据也很有说服力。gpt-oss-120b(每token约2.1GB)跑出55.9~56.4 tokens/s,反超9B稠密模型的 42.5~44.4 tokens/s(5.6GB)。换算后各组均逼近300GB/s带宽上限,说明软件层几乎无损耗。Nemotron 74B连续输出17180 token仅衰减约2%,gpt-oss-120b则基本无衰减——MoE + Mamba架构在长输出下不会“越写越慢”。
AIGC侧同样亮眼:ComfyUI原生ARM64 版跑满血bf16的Qwen_image_2.1,1536×2720分辨率出图141.34秒,显存占用达25GB,GPU始终用自身高速带宽做矩阵运算——这是16GB/24GB旗舰独显根本做不到的。文生视频用Minimaxh3工作流生成1280×736/5秒耗时 413秒,长负载全程稳定输出。
在生产力性能部分,Cinebench Arm64版测试中,RTX Spark N1X的CPU多线程表现与中高端X86处理器相当、单核达到X86旗舰水平。在支持DLSS降噪的Blender 5.3.0 Alpha中,改变光照或动态预览时细节更清晰、画面恢复极快,省下的正是设计师的等待时间。当然,由于RTX Spark N1X的GPU可以享受RTX GPU的全部生态,所以在其他支持RTX GPU黑科技的生产力软件中,它也可以发挥出独有的优势。
游戏方面,RTX Spark N1X的GPU在3DMark TimeSpy GPU测试中得分高达13358分,高画质通吃主流游戏大作,百帧畅玩不在话下,虽然华硕ProArt 创16 RTX Spark是创作本,但它在游戏方面的表现完全不输高端游戏本。
综合来看,华硕ProArt 创16 RTX Spark的产品定义很清晰,它把RTX Spark装进了一台真正能随身携带的专业AI智能体轻薄本,是把本地AI从“能跑”推进到“能干活”的第一代AI智能体PC平台。它能本地加载120B级别模型、跑168轮智能体交互、本地输出2K满血bf16图片,同时数据不上传、也不用为每次请求支付token账单。因此,对于AI开发者、重视素材隐私与token成本的设计师与内容创作者,以及需要移动工作站的专业用户,它算得上是当下最有说服力的选择。