

AMD的EPYC(霄龙)系列处理器自初代发布以来已经历六次迭代,每一次都带来了里程碑级的进化,助力AMD在服务器和高性能计算市场一路攻城略地,在AI时代更是抓住机遇突飞猛进,目前已经稳坐领军之位。最近,AMD在美国拉斯维加斯举办的AMD In Depth 2026技术交流会上揭开了代号“Venice”的第六代EPYC处理器的完整技术细节,并同步推出面向智能体时代的Helion与Helios机架方案。这一代EPYC处理器专为Agentic AI时代而生,从微架构到平台设计,处处体现着对新负载形态的精准定位,接下来就让我们一起来对它进行一个全面的了解。
EPYC一路走来所向披靡,第六代“Venice”再攀巅峰
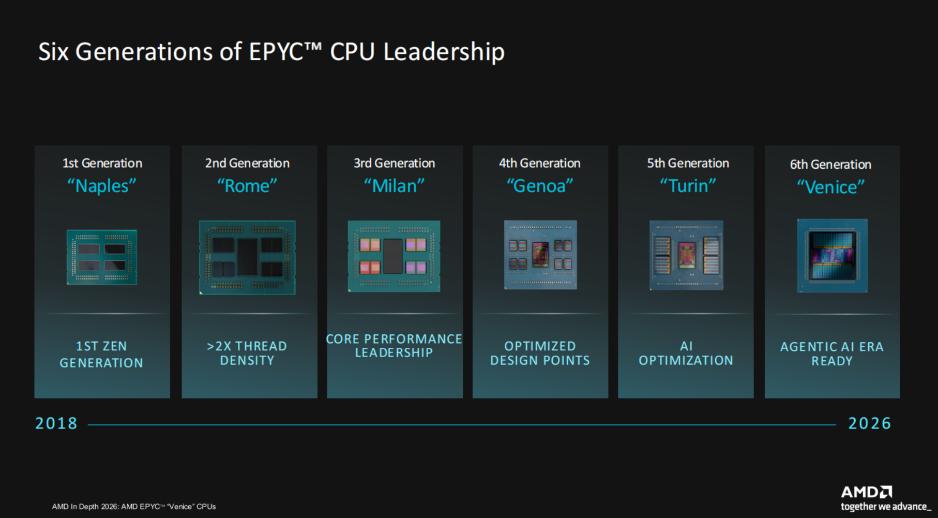
EPYC从2018年登场的第一代“Naples”,历经五次进化来到第六代“Venice”,每一代都在成长路线上留下了深刻的脚印。
第一代“Naples”:首代Zen架构,把Chiplet设计与高核心数策略首次带入x86服务器市场,一举改写竞争格局。
第二代“Rome”:线程密度达到2倍以上,核心数与并发能力实现一次跨代。
第三代“Milan”:核心性能领先,IPC与频率全面进步,在性能敏感场景站稳脚跟。
第四代“Genoa”:优化设计点,DDR5、PCIe 5.0与CXL齐备,精准覆盖云、企业与HPC场景。
第五代“Turin”:针对AI优化,乘着AI时代的东风扶摇直上,成为AI推理与通用混部的算力底座。
第六代“Venice”:智能体AI时代就绪,从架构定义阶段就把“Agentic AI”写进设计原点的EPYC处理器。
EPYC这条演进线上,前三代解决“有没有”和“强不强”,第四、五代解决“合不合适”和“AI不AI”,而第六代把箭头直接对准了负载形态本身。当然,市场端用真金白银为这条演进线做了背书。据AMD官方数据,财富100强企业中的大多数已将数据中心托付给EPYC;每一周,都有一家福布斯全球2000企业转向AMD平台;生态中已积累475+个来自OEM的EPYC平台、1650+个EPYC驱动的虚拟机实例。而在刚公布的AMD第三季度财报中,AMD数据中心业务几乎翻倍,同比增长97%,创下85亿美元的纪录。

6代产品的演进中,更惊人的是吞吐量曲线,以第一代旗舰EPYC 7601为1.0基准,第二代7742达2.4倍,第三代7763为2.9倍,第四代9654为5.3倍,第五代9965为10.1倍,第六代9996达到19.9倍,实现近20倍的代际累计提升,且最近两代斜率明显变陡,这个迭代加速度可以说是相当惊人了。

在与第五代“Turin”的对比中,“Venice”的实际提升非常抢眼:SPECint 2026整数性能达到2倍、SPECfp 2026浮点性能2.4倍、STREAM内存带宽2.7倍、HPL科学计算1.4倍、DGEMM矩阵计算1.3倍。整数、浮点、内存带宽同时领先,这可不是偏科式的强,而是平台级的全面代差。
为什么说“Venice”专为智能体AI而生?
其实关键就在于负载形态的根本差异。智能体AI不是单一的大规模矩阵乘法,而是“推理➡工具调用➡记忆读写➡再推理”的长链路任务:并发请求突发而至,KV-cache与上下文长期驻留内存,步骤间数据搬运频繁,多租户场景又要求严格隔离。这就对CPU提出了四重诉求:拥有足够的单线程性能与低延迟、足够的线程与内存带宽、足够的内存容量与成本弹性、足够的机密性与隔离能力。
而后面我们分析的几个部分,正是从这4个维度逐一进行展开回答:微架构解决吞吐与延迟;平台与互联解决内存、I/O与数据搬运;电源管理解决机架经济学;安全与MEXT解决信任与内存成本;Helion与Helios机架则把领导力一路推到机架级方案。
负载侧:智能体把CPU推回舞台中央

先看负载侧的数据。AMD官方资料显示,高盛预测:AI智能体的月度token消耗量到2030年将增长24倍,其中企业级智能体与消费级智能体各占一条陡峭曲线。这不是线性增长,而是一条指数级的需求曲线,为此数据中心必须先回答“算力从哪来”。

更关键的是结构性变化。据AMD官方资料,聊天机器人时代(2022-2025年),数据中心里CPU与GPU的配比大约是1:4;而进入智能体时代(2026年起),这个比例变为1:1并且还在继续上升。原因不难理解,智能体不只是“问一句答一句”,它要规划、要调工具、要读写记忆、要校验结果,而这些工作大量落回CPU身上。可以说,智能体AI首先是一场CPU的回归战。
8级流水线:每一级都对CPU提出独特要求

AMD把智能体AI拆成一条八级流水线:网关与路由、上下文组装、规划与路由、上下文检索(RAG)与相似度搜索、推理、临时工具、校验与批判、流式响应。每一级的“胃口”都不一样:有的吃网络并发,有的吃内存带宽与容量,有的吃隔离与安全,有的吃加速能力。智能体AI持续穿行于计算、内存、I/O、安全与加速密集的各个阶段,这反映出它对CPU的要求。

而对着这八级流水线逐段检验,“Venice”的成绩单相当好看。AMD官方资料显示,以Intel Xeon 6980P为基准进行比较,“Venice”的网关与流式响应达到2.8倍、规划/路由/校验3.5倍、上下文检索2.4倍、企业工具2.7倍。可见五个层段全面领先,最高3.5倍,这已经不是某一项跑分的胜利,而是整条流水线的胜利。

最值得单独说的是临时工具层。官方数据显示,那些随起随灭、成千上万并发spawn的短生命周期沙箱任务,是智能体时代增长最快的一层。在这一层,256核的“Venice”是Xeon 6980P的2.5倍,也明显领先Graviton5(1.4倍)与自家上代Turin(1.7倍),增速最快的地方,恰恰也是它领先最多的地方。
所以“专为智能体AI而生”不是一句口号:它是把八级流水线逐段拆开、每一段都给出领先答案之后才配得上的结论。
Zen 6架构进化:IPC提升约27%,AI负载受益最大
AMD高级副总裁、企业院士及首席架构师Mike Clark把Zen 6家族的设计目标归纳为五条:再交付一次重大的核心性能提升;充分利用高效设计风格以获得最大吞吐;增强面向智能体计算负载的AI能力;强化最低延迟运行点的能力;持续扩展机密计算能力。五条归结在一起就是:“Flexible Computing for the Agentic Era”(智能体时代的灵活计算)。
Zen 6c微架构:更宽、更大、更强

用“更宽、更大、更强”三个词来概括Zen 6c微架构再合适不过。前端采用2基本块取指与8宽派发/重命名;执行侧配置6个ALU、4加载/2存储访存端口、512位浮点数据通路与2周期FADD;缓存侧为48KB数据缓存与64字节fill/victim通路。
分支预测:2-taken、2-ahead的TAGE预测器,返回地址栈扩至64项,每周期最多2个taken分支。
前端带宽:64B/周期取指,Op-cache扩至6.75K项,采用双路 9 宽输出,每周期最多交付18个操作。
执行窗口:352项整数物理寄存器堆、640项ROB;整数调度器改为分布式设计,96项共享队列外加48项专用ALU队列。
访存与TLB:L1数据缓存48KB 12路、4周期加载延迟,每周期4加载/2存储;加载队列扩至80项、存储队列128项。
向量与AI:512位全宽数据通路,VNNI INT8流水线增至4条,为量化推理与检索类负载打下硬件吞吐基础。
值得注意的是,Zen 6c并非简单“加宽”,而是对几个最影响多线程服务器负载的结构做了重构。分布式调度器、更大的ROB与存储队列,都指向同一个目标:在高线程数、大在途窗口下仍保持效率。这正是在微架构上对智能体负载“高并发+长链路”特征的针对性设计。
与Zen 5对比:每一步都是实打实的升级

浮点流水线的变化相当务实:FP16从“仅转换”升级为完整AVX-512 FP16计算;新增BMM(位矩阵乘)指令;VNNI-INT8从2条流水线加倍到4条;浮点加载带宽升级为2个512b加载或4个256b加载。这些变化直接利好低精度推理与嵌入计算:智能体负载中的常客。

32核复合体的缓存层级同样豪华:每核独享1MB L2,32核共享128MB 16路L3,L3主要由L2 victim行填充近似独占设计,且L2标签在L3中复制以做probe过滤与快速传输。单核心支持127个L2到L3的在途缺失,整个复合体支持1280个L3到内存的在途缺失,在途窗口相当大。

家族两个分支定位各异。和Zen 5c相比,面向云吞吐的Zen 6c:单复合体核心数从16翻倍到32,每核L3从2MB到4MB,复合体总L3缓存从32MB扩容至128MB(4倍),最高频率3.7GHz提到4.1GHz,插槽最大核心数192增加到256。和Zen 5相比,面向高频的Zen 6:CCX核心数从8核增加到12核,最高频率5.0GHz提升到5.3GHz,每核L3保持4MB、CCX总L3由32MB增加到48MB,最大核心数由64核增加到96核。总而言之,Zen 6c把插槽吞吐做到极致,Zen 6把单线程延迟做到极致。

ISA更新分为四组:指令类(完整FP16、AVX-VNNI-INT8、AVX-NE-CONVERT、AVX-IFMA、BMM);内核与虚拟化类(FRED新用户/内核接口、PML客户脏页记录、PLZA特权级切换自动服务类变更);安全类(SEV-SNP的RMPOPT、DIRTY位热迁移优化、增强SMT保护);性能分析类(Memory Profiler、IBS Buffering)。其中FRED与PML显著降低虚拟化与系统调用开销:那可是智能体基础设施里最频繁的代码路径。
IPC提升约27%:AI负载受益最大

直接看官方的测试数据:在固定频率、16核跨2 CCD对16核单CCD的口径下,Zen 6c相对Zen 5在AI与服务器负载上实现了约27%的几何平均IPC提升,其中AI负载几何平均提升约31%,企业与云服务器负载几何平均提升约20%。由此可见,Zen 6的微架构改进在AI类负载(更多分支、更多低精度向量操作、更大在途窗口)上收益更大,与“智能体优先”的设计宣称完全吻合。

把Zen 6c与Zen 5c的关键参数摆在一起,可以看到几乎所有决定“同时能容纳多少在途工作”的结构都扩张了三成到七成,每核L3更是直接翻倍。把这个表与IPC数据放一起,就可以看出提升不是靠某一招鲜,而是“前端交付➡调度窗口➡访存队列➡缓存容量”的系统性扩张。对服务器CPU而言,这种提升比频率提升更难做工程实现,也更难被单一负载绕过,这也是Venice在架构进化上最难能可贵的地方之一 。

最后,AMD把Zen 6的价值总结为四根支柱:性能领导力;以差异化设计交付最大吞吐与最低延迟;面向智能体负载的增强AI能力;扩展的机密计算能力。这四根支柱,正是后面平台部分的逻辑骨架。
SP7/SP8平台双管齐下:一个管带宽容量,一个管I/O密度

接下来是SoC与平台部分。从AMD官方的资料可以看到,Venice家族共享同一套Zen 6计算Chiplet,却衍生出了SP7、SP8、Venice-X SP7与Verano四种形态,我们来逐一看个究竟。
SP7:旗舰插槽火力全开

SP7是Venice的旗舰插槽。计算侧支持Zen 6/Zen 6c两种CCD,最多8个CCD:Zen 6c配置每CCD 32核,插槽最高256核512线程;Zen 6配置每CCD 12核,最高96核192线程。每核1MB L2、每CCD最高128MB L3;带3D V-Cache缓存的“Venice-X”变体L3可达惊人的1152MB。芯片互联升级为第五代Infinity Fabric,并引入FAST(频率自适应频谱技术)与增强的内存带宽监控作为QoS手段。
内存侧:支持16通道DDR5 ECC,RDIMM最高8000 MT/s,MRDIMM最高12.8 GT/s;支持1/4/8/12/16通道交织;插槽带宽最高1.6 TB/s;每通道1根DIMM、插槽容量最高8TB(基于512GB 3DS RDIMM)。16通道的内存插槽,看起来是不是十分壮观?
I/O侧:双路最高128条PCIe 6.0通道(64 Gbps/通道)外加16条bonus PCIe Gen4通道,单路96条加8条bonus;支持×16/×8/×4/×2拆分;原生支持CXL 3.1、SDCI(智能数据缓存注入)与SDXI(智能数据加速器接口,带加密能力的数据搬运器)。
平台与安全侧:全新紧凑插槽76×80 mm;IRM供电规格最高600W;平台级电源特性包括UBPS与UPP;双路最高3条64Gbps Gen5 Infinity Fabric链路。安全方面覆盖增强RSA 4K与PQC支持的信任根、专用安全子系统、降低RAS影响的密文隐藏能力、物理与侧信道攻击缓解,以及完整的机密计算家族SEV/SEV-ES/SEV-SNP/SEV-TIO。
Chiplet组合:CCD的爆炸式升级

先看新的CCD。AMD官方资料显示,Zen 6c CCD为32核配128MB L3,相对Zen 5c(16核/32MB)实现CCX核心数达到2倍、L3达到4倍;Zen 6 CCD为12核配48MB L3,是Zen 5(8核/32MB)的1.5倍;频率亦全面提升。CCD到IOD的数据通路增强了probe响应(32B)与写密集流量(25B)性能;CCD 32加入冗余核心以提升良率;当然,最抢眼的是CCD部分都采用了TSMC N2工艺:目前量产的最先进节点。
双IOD与EFB互联

IOD侧:搭载双IOD,每个集成8个DDR5通道(支持MRDIMM 12.8 GT/s 1DPC),合计16通道,理论峰值带宽1.6 TB/s;每个IOD提供48条64G SERDES与8条16G SERDES,全插槽合计96条64G加16条16G。die-to-die通信采用Elevated Fanout Bridges(EFB),显著降低pj/b,带来更低延迟与更多每核可用功率。
NPS配置:把选择权交给运营者

官方还给出了每插槽内存节点拓扑:16通道由两个IOD分管,系统可按NPS1/NPS2/NPS4组织为不同NUMA节点数以优化部署。HPC与延迟敏感负载倾向更少节点以获得更简单的编程模型,吞吐型云负载则可用更多节点换取更好的带宽局部性。Venice默认NPS2性能取向,同时保留NPS1兼容与NPS4特定OPN支持。
三大优化区间:把“功率契约”写进SKU

这份优化区间表实际上就是一份“功率契约”:批量智能体负载(256核@400W,利用率区间50%~100%,每核功率1.2W~2.0W,追求计算密度与吞吐每瓦);云与MDC均衡型(256核@600W,30%~100%,1.7W~3.5W/核,平衡每核性能与TCO);面向HPC、头节点与桌面的高频型(96核,500W/600W,15%~100%,5W~10W+/核,更宽的动态范围服务突发低延迟场景,可冲击5.0GHz以上)。

AMD官方资料用三句话来概括了SP7平台级进步:以JEDEC标准(非专有)DIMM实现最高2.6倍内存带宽提升;以PCIe Gen 6实现每通道I/O带宽翻倍;以CXL 3.1实现内存扩展。注意“JEDEC标准”的强调:带宽提升不以专有内存生态锁定为代价。
SP8:面向scale-out的密集IO变体
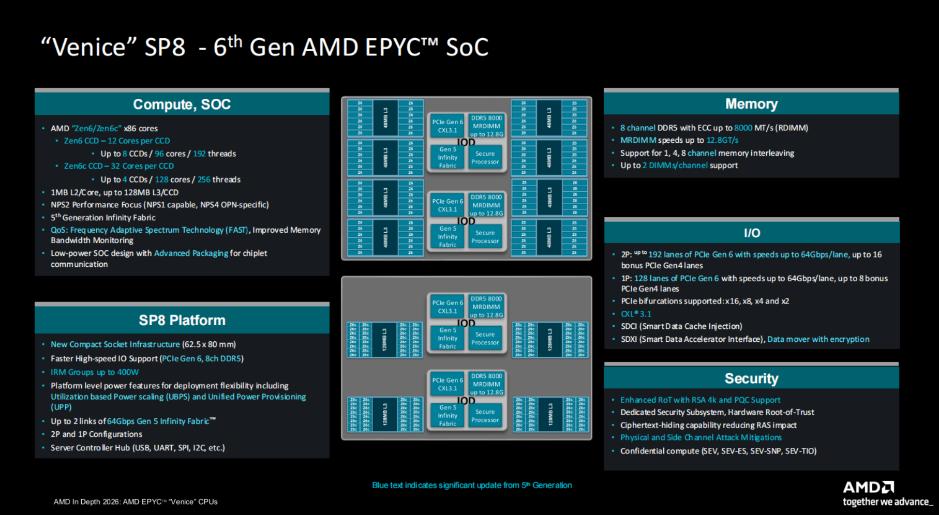
SP8则面向scale-out与边缘密集场景:拥有8通道DDR5(每通道最多2 DPC);计算侧最多4个CCD:Zen 6c配置最高128核256线程,Zen 6配置最高96核192线程;I/O侧反而更强:双路最高192条PCIe 6.0通道加16条bonus,单路128条加8条bonus;插槽尺寸缩至62.5×80 mm,IRM最高400W。
SP7对SP8:一次清晰的"内存换IO"取舍


从表格中的规格对比可以看到,SP7和SP8两者的差异是一次清晰的“内存换I/O”取舍。SP7以16通道1DPC换取带宽与容量(峰值1.6 TB/s、2TB/插槽),SP8则以2DPC容量弹性与更多PCIe通道(2P 192条、I/O峰值2.0 TB/s)见长,代价是内存带宽降至819 GB/s(MRDIMM口径)。用户可以按“内存优先”还是“I/O优先”来按需选择。
Verano与家族总结

官方资料还介绍了家族第四位成员“Verano”:最多6个CCD,内存改为6组LPDDR5x SOCAMM模块(合计24通道,最高8533 MT/s),支持现场更换;计算DIE采用TSMC N2P工艺;SB1平台功耗最高500W,定位AI主机节点。Verano以LPDDR5x换带宽与能效,适合对内存带宽与部署密度敏感的AI头节点场景。
总而言之,SP7、Venice-X SP7、SP8、Verano四种形态共享同一套Zen 6计算Chiplet与平台技术,构成覆盖TCO、性能与能效的完整产品组合。
平台技术火力全开:内存、I/O、电源与安全
内存组合:一页纸上的五种形态

AMD官方资料把Venice的内存技术矩阵摆在一起:DDR5 MRDIMM Gen2(12800,1.6 TB/s)服务带宽受限的云、AI与HPC;DDR5 RDIMM(8000,最高8TB/插槽)服务主流计算场景;LP5X SOCAMM2(最高约0.8 TB/s、同带宽下功耗低30%~40%)服务Verano平台;CXL 3.1(SP7最高96条通道、SP8最高128条通道,每×16约128 GB/s原始带宽)服务容量与成本优化;MEXT(延迟影响<4%、有效容量2~4倍、闪存单价最高比DRAM便宜30倍)服务TCO敏感型基础设施。
CXL内存:terabyte级内存层

资料把CXL定位为“terabyte级内存层”,容量侧支持每插槽multi-TB,单位成本比DDR5低87%;带宽侧支持软件交织做带宽扩展;内存分层侧提供AMD独有的SDXI/DACC能力,同时具备带宽QoS能力;应用侧无需任何修改。对KV-cache与上下文海量驻留的智能体负载而言,CXL提供了一层“足够近、又足够便宜”的内存。
PCIe Gen 6:带宽、虚拟化与能效并进

官方把PCIe技术归为四组:带宽类(64 GT/s Gen6链路、256B Flit Mode、面向 AI、HPC 与高吞吐网络);灵活系统配置类(原生链路拆分至 x2、放宽排序、MCTP over PCIe VDM、PCIe PTM 精确时间测量);虚拟化与机密计算类(SEV-TIO与Selective IDE、Link IDE、机密设备分配、更强的虚拟机隔离);RAS类(原生 PCIe 机框管理、同步/异步热插拔、高级错误上报);能效类(主动链路状态管理、设备发起的L0p、Direct Cache Injection)。
xGMI:三种灵活的互联工作方式

AMD官方资料给出SP7双路通用计算的两种拓扑:“IO最大化”模式用2 组 G-link 做 xGMI互联,让出一组G-link换取2条×16 PCIe设备扩展;“CPU间带宽最大化”模式则把3组G-link全部用于xGMI,获得最大跨插槽带宽。两种模式下底部均保留6×16 PCIe设备扩展,用户按负载的跨插槽流量比例自由选择。

官方资料进一步展示了加速器互联的灵活性:1P场景加速器复合体可经×16直连PCIe接入;2P场景支持1×16 xGMI跨CPU互联,并以直连或线缆化PCIe接加速器,两种物理形态可按场景组合。同时还给出了面向Instinct MI450X GPU的互联方案:SP7为其提供4×16 @64Gbps的xGMI连接,让CPU在AI系统中成为GPU的等带宽伙伴。
SDXI:不征CPU税的数据搬运

AMD官方资料介绍的SDXI(Smart Data Accelerator Interface)是SNIA行业标准的数据搬运器规范:单引擎吞吐100 GB/s,每插槽2引擎合计200 GB/s;内置AES+SHA加密加速,网关加密带宽每插槽50 GB/s;支持用户态提交与共享虚拟内存。AMD的数据体现出一个直观的换算:SHA-256卸载约等于省下30个核心。
应用场景直接指向智能体的各个环节:KV-cache分层与迁移、RAG ingest加速、存储加速。用AMD的话说,“智能体的每个阶段都在搬数据:模型权重、KV-cache、请求载荷、工具输出”,SDXI的价值就是让这些数据以线速移动而不耗费CPU周期。与CXL内存层配合,SDXI/DACC构成了AMD对“内存墙”的差异化解决方案。
三个实时控制轴:功耗成为可编程资源

从AMD官方资料可以看到,“2026年数据中心运营者三难”:电力搁浅➡15%~25%的机架容量因按最坏情况冗余设计而闲置;空闲/低利用率电力渗漏➡即使利用率极低仍消耗峰值功率的60%~70%,典型云运营者利用率曲线下平均浪费约25%的电力;SKU蔓延➡premium与批量VM需要不同的核,被迫准备2~3倍物理SKU,从而带来翻倍的验证、库存与OPN成本。

AMD官方给出的答案是“三个实时控制轴”:UPP(统一供电配置)管“多少”➡合并SoC与DIMM功耗预算,回收搁浅的机架容量,每个35kW机架可多装1~2台服务器;UBPS(基于利用率的功耗缩放)管“何时”➡功耗随活跃核心数实时伸缩,典型利用率下维持低功耗、突发到来时释放满功耗;FAST(频率自适应频谱技术)管“哪里”➡按核心组设定保底频率,premium与非premium等级集成于同一SoC,一个物理SKU对应多个OPN等级。

AMD进一步把三个轴的运营者价值归结为:UPP带来每机架更多服务器与更好的perf/TCO;UBPS带来更低OPEX与更小的峰值SLA风险;FAST带来软件许可成本优化、供应链简化与更低的平台验证投入。从芯片到机架,功耗第一次成为“可实时编程的资源”,这是Venice最具运营者思维的设计之一。
RAS:从错误注入到可预测延迟

官方展示的RAS能力覆盖九个方向:扩展的OCP RAS API、增强SMI-free RAS、专用RAS微控制器、错误注入(PCIe/CXL/内存)、增强的Infinity Fabric链路报告、改进的机器检查架构、可预测延迟、无缝集成与标准接口、安全性。对大规模智能体基础设施而言,SMI-free与可预测延迟的价值在于避免RAS处理带来的长尾延迟抖动,那是多轮推理服务隐形却关键的SLA要素。
安全:从机密计算到后量子与设备溯源

安全方面,AMD给出了五大支柱:灵活机密性(SEV到SNP到TIO频谱,支持SNP与标准VM共置);PQC就绪(满足NIST后量子要求的密码敏捷平台);零信任到硅(Caliptra 根信任与完整证明链,开源可审计);AI负载安全(机密推理与数据主权);平台控制(BYOK、所有者授权、无厂商锁定)。
进一步展开讲,Venice提供首个x86机密计算设备溯源能力,可证明的溯源覆盖完整设备制造生命周期;SEV/SNP/TIO将机密性扩展到CXL内存与,以及兼容TDISP的PCIe设备;证明支持带外SPDM与带内DPE;链路加密覆盖PCIe IDE与Infinity Fabric链路;支持Owner Authorization将x86 BIOS绑定到客户PKI、以及支持“无回传”;安全引擎通过FIPS 140-3 L1要求,全栈接受周期性第三方OCP S.A.F.E.审计并公开报告。
安全能力还延伸到供应链与生命周期:设备溯源提供与行业标准对齐的不可变元数据、绑定设计文件到硅片绑定的密码签名、以及第三方红队审计框架;智能体AI安全就绪则覆盖从硅基根信任、安全启动、证明、负载隔离、密钥管理、链路加密、运行时监控到安全退役的全链路。
对智能体时代而言,安全已从单纯的“合规项”变为“业务前提”:当智能体代表企业调用工具、读写数据时,机密计算与可证明溯源是把这类负载放上共享云或主权云的唯一途径。Venice把PQC、TIO与设备溯源做成平台默认能力,本质上是在为智能体经济预置“信任基础设施”。
Helion与Helios机架:把CPU领导力推向机架级方案
光是CPU叙事当然不够。智能体时代给数据中心出了三道新题:智能体负载成倍增长,需要领导力计算;机架需求开始分化,需要开放的机架级方案;部署复杂度攀升,需要可扩展的软件框架。AMD的答案是三点:对的CPU、对的机架、对的伙伴。前面讲完CPU,接下来就讲机架和伙伴。
机架级对决:对上NVIDIA Vera的三组数字

先看芯片维度,根据AMD官方资料,和NVIDIA Vera相比,“Venice”吞吐量约2.8倍、单核性能约1.3倍、内存带宽约1.3倍,这分别对应三件事:更高的智能体密度、更低的智能体延迟、喂得饱并发智能体。

再上机架维度,数字更狠。官方给出的对比是:每兆瓦系统功率内的线程数约2.9倍、性能约2.0倍;每机架核心数上,AMD Helion机架的32,768核对Vera ETL256机架的22,528核,领先1.45倍。注意前提条件:Venice是256核400W,Vera是88核450W,核心数更多、功耗还更低,这个机架级领先含金量有多高大家也是有目共睹了。

别忘了前面讲过的UPP。AMD官方资料显示,把SOC与DIMM功耗合并为一个预算、回收机架里被搁浅的电力之后,每插槽智能体数最多可提升1.2倍;官方测算在35kW机架中,功耗上限下调10%可得1.11倍每机架智能体、下调15%可得1.18倍,而性能损失几乎为零。电力,就这样被变成了可编程资源。
四种机架形态:把选择权交给客户


AMD官方资料显示,Helion与Helios一共四种配置,从纯CPU到CPU+GPU、从风冷到液冷全覆盖:单机架36864核是什么概念?按每插槽256核折算,相当于上百颗旗舰CPU塞进一个机架,这是液冷加高核心数共同撑起来的密度底气;而Helios那一栏的72× MI455X加5.3GHz高频CPU,则把“CPU+GPU液冷整机架”的旗舰形态也一并给出了答案。
开放还是封闭:一道路线选择题

机架市场有两条路线,封闭路线意味着单一CPU选择、有限生态、被规定的机架设计;AMD选的是另一条:宽而开放的CPU选择、开放生态、灵活的机架配置。官方的说法很直接:为你的智能体机架部署,选择一个成熟而开放的伙伴。对客户而言,这不只是情怀,开放意味着不被单一供应商锁死,意味着既有生态可以直接复用。
软件参考架构:把一排机架变成一个智能体平台

AMD把八级流水线映射到三类基础设施:GPU服务器承担推理;智能体CPU服务器(host node)承担网关、组装、规划、检索、校验与流式响应;通用CPU服务器(sandboxes)承担临时工具。软件层则是ROCm Agentic Toolkit,用软件把一排机架粘成一个平台。
再往下是两个关键部件。一是智能体控制面:会话连续性(恢复、检查点、过期)、放置决策(拓扑、NUMA、健康、容量)、策略与身份(租户、出口、硬件证明);二是安全执行后端:会话沙箱提供持久工作区,工具沙箱提供一次性执行,隔离后端支持AXIS、Docker、gVisor、Kata、Firecracker与MXC。一句话:持久会话管连续性,沙箱管安全执行。
模型路由器则按策略、语义、容量三条轴决定“对的模型放在对的地方”,并明确承诺不跨策略边界静默回退;MEXT与AIC负责KV与上下文复用,Helion承接云与主权LLM的放置目标,Helios负责本地加速LLM服务。至此,软件把机架组合真正变成了一个可管理、可治理的智能体AI平台。
MEXT黑科技:用AI管内存,让闪存扮演DRAM
DRAM太贵,也太浪费

先说钱的事。AMD官方资料的服务器成本拆解显示,DRAM与处理器一同占据服务器成本的大头;资料还回顾了DRAM单价史:从1974年约5000万美元/GB到2012年约8美元/GB,累计降幅约600万倍,但底层1T1C架构半个世纪未变,单价下降曲线近年明显趋平。
更扎心的是浪费。官方引用Meta TMO与Azure Pond研究指出三种浪费:50%的VM从未访问过自己一半的DRAM(过度配置);25%的内存页会趋于"冷却"(搁浅);搁浅内存占总DRAM的比例高达50%-80%。AMD给出的热力图更直观:负载运行数分钟后,大部分容量即已冷却。
三个约束与一个矛盾

资料给出方案的三个约束:不做任何硬件或软件修改;消除过度配置与搁浅、提升利用率;把闪存引入内存域,闪存比DRAM便宜50倍、功耗低30倍,但慢500倍。MEXT的全部设计,都围绕化解最后这个矛盾展开。
Linux驱动 + AI引擎 + RAM View

MEXT的原理可以用一句话概括:透明地把冷页卸载到闪存,AI把即将被需要的页提前推回DRAM,“让闪存表现得像DRAM”。官方给出三个组件:轻量低开销的Linux内核模块(适配任意Linux发行版);AI引擎(含基于Transformer的LLM模型集合);RAM View可观测平台(实时可视化内存利用)。

AMD官方资料进一步解释AI引擎:像LLM但面向内存页,实时持续训练与推理,训练完成不到1秒,只占用1个EPYC核心、不需要GPU,并支持实时自我改进。这种“以AI治内存”的思路,与智能体时代“用模型管理系统”的技术叙事一脉相承。
价值:成本与容量两条轴


官方给出两条价值轴:成本侧,配合MEXT以闪存作内存,可在维持性能的前提下削减20%~75%的DRAM配置,提升每DRAM美元性能;容量侧,可将有效内存容量扩展至最高3倍,成本远低于直接加DRAM。
实测数据:Agentic、EDA与Spark

数据最有说服力。AMD官方资料的智能体AI基准(第六代EPYC平台)显示:50% DRAM + 50% MEXT配置下,并发5智能体几何平均保持全DRAM性能的99%,性能/DRAM成本比为1.9倍;内存饥渴型单智能体保持90%性能、比值1.7倍。25% DRAM + 75% MEXT配置下,并发5智能体保持85%性能、比值3.4倍;内存饥渴型智能体保持88%、比值3.5倍。


EDA与大数据场景同样有说服力。官方资料显示,Synopsys PrimeTime在第六代EPYC上,削减50%/62.5%/75% DRAM分别对应95%/90%/80%的性能,与1.9/2.4/3.2倍的性能/DRAM美元;同一份资料还提到,Azure上第五代EPYC虚拟机运行Spark TPC-DS,同一3节点集群以50% DRAM + 50% MEXT保持99%性能;而在Azure HX系列的PrimeTime吞吐案例中,MEXT把1.4TB DRAM的作业扩展为2.6TB有效容量,每小时吞吐提升1.4倍,单作业时间从9.3小时缩至6.6小时。
部署实践:AMD IT自己的案例

官方展示的RAM View案例颇具冲击力:一台看起来配置合理的1.5TB系统,实际利用率更接近768GB,其余皆为冷数据。AMD给出本地部署两阶段路径:现有MEXT Ready服务器(充裕核心、专用NVMe盘或盘位)加MEXT许可与预装RAM View即可启用。AMD IT自身的实践更有说服力:初始145台服务器部署中,以MEXT实现同等内存扩展,相比全DRAM方案节省83%成本(约避免490万美元DRAM采购,256GB DIMM单价约1.55万美元),并计划于2027年扩展至2000台。
总的来说,MEXT这项“黑科技”的意义超出了单一的硬件产品:它把“内存配置”从硬件采购决策变成软件可运营的资源。对上下文与KV-cache飞速增长的智能体基础设施而言,这种弹性可能比任何单项基准提升都更实在。
总结:Agentic AI时代,Venice再次稳固AMD领军地位
最后来简单总结一下。我们回到最初的问题:为什么说EPYC 9006“Venice”专为智能体AI而生?拆解完以上七个层面,相信答案已经清晰。
微架构层:Zen 6c约27%的几何平均IPC提升(AI负载约31%)、8宽前端、640项ROB与4倍INT8流水线,为长链路、高并发的智能体负载提供吞吐与低延迟。
平台层:256核/512线程、16通道DDR5 MRDIMM 1.6 TB/s、PCIe Gen 6与CXL 3.1,加上灵活的xGMI拓扑与SDXI数据搬运器,把内存、IO与数据搬运的瓶颈在平台级化解。
电源层:UPP/UBPS/FAST三个实时轴把机架电力从“静态冗余设计”变成“实时可编程资源”,直接回应云运营者的TCO与电力搁浅痛点。
安全层:SEV-SNP/TIO、PQC就绪、Caliptra RoT与设备溯源,让机密计算与可证明信任成为平台默认能力,支撑多租户智能体服务与数据主权。
经济学层:MEXT用AI把闪存引入内存域,削减20%~75%的DRAM成本或扩展3倍容量,缓解智能体时代最直接的成本压力➡内存。
机架与软件层:Helion/Helios四种机架形态把密度与能效领导力推到机架级(每兆瓦线程2.9倍、每机架核心1.45倍),ROCm Agentic Toolkit、控制面与沙箱体系则把硬件组合变成可管理的智能体平台。
这七层不是并列的功能堆叠,而是围绕同一种负载形态的设计闭环。这正是Venice留给行业最深的印象:它不是“更快的CPU”,而是“围绕智能体负载重新定义自己的CPU”;它不是单打独干,而是组成智能体全链路方案的关键一环。

另外,AMD在Agentic AI时代的领先,很大程度上是一种“节奏领先”。AMD官方资料给出了两张路线图:一张是CPU与机架路线图:2024年的Turin(Zen 5/5c)、2026年的Venice(Zen 6 /6c)、2028年的第七代EPYC Florence(Zen 7/7c)、2030年的第八代EPYC Ravenna(Zen 8家族),两年一代、步步衔接。
其中Florence的定位尤其能说明问题:下一代工艺节点、ACE(AI Compute Extensions)AI计算扩展、以及MRDIMM与LPDDR在内的下一代内存,也就是说,智能体时代的架构演进不是Venice一代的独角戏,而是一条排到2030年的产品主线;而第八代Ravenna已经处于开发中。

机架侧的节奏与之完全咬合:2026年的Helion搭载第六代Venice,2028年的Helion Gen 2搭载第七代Florence,2030年的Helion Gen 3搭载第八代Ravenna。机架跟着CPU代际走、固定周期迭代。这意味着AMD已经把机架做成了和CPU一样有节奏感的产品线,这正是机架级方案供应商该有的打法。

从目前的进度来看,AMD官方资料用A Generation Ahead(领先一代)概括了四个现状:Venice SP7平台按序出货、产品组合交付在轨;性能维度保持最高频率、最高线程数与最高内存带宽;智能体AI维度做到每机架最多智能体、每瓦最多智能体、最快智能体启动;Helion智能体机架提供3种机架选项并获得OEM与ODM支持。
把两张路线图和这份出货现状放在一起看,结论就很清楚了。AMD在Agentic AI时代的领先,不是某一代产品的领先,而是整条节奏的领先。CPU两年一代的cadence、机架代际随动的跟进、以及当下按时出货的执行。竞争对手或许能追上某一代产品,但很难追上一整套节奏。
从竞争格局看,19.9倍的吞吐量曲线与SPECint/SPECfp/STREAM/HPL/DGEMM的全面领先,说明AMD在服务器CPU主航道上仍在扩大优势;而SP7/SP8/Venice-X/Verano四形态组合与MEXT软件层,则显示其正从芯片供应商向平台与解决方案供应商延伸。在AI智能体服务器、HPC与云场景,AMD凭借这一代产品继续维持、并在若干维度上进一步巩固着AI基础设施领军者地位。